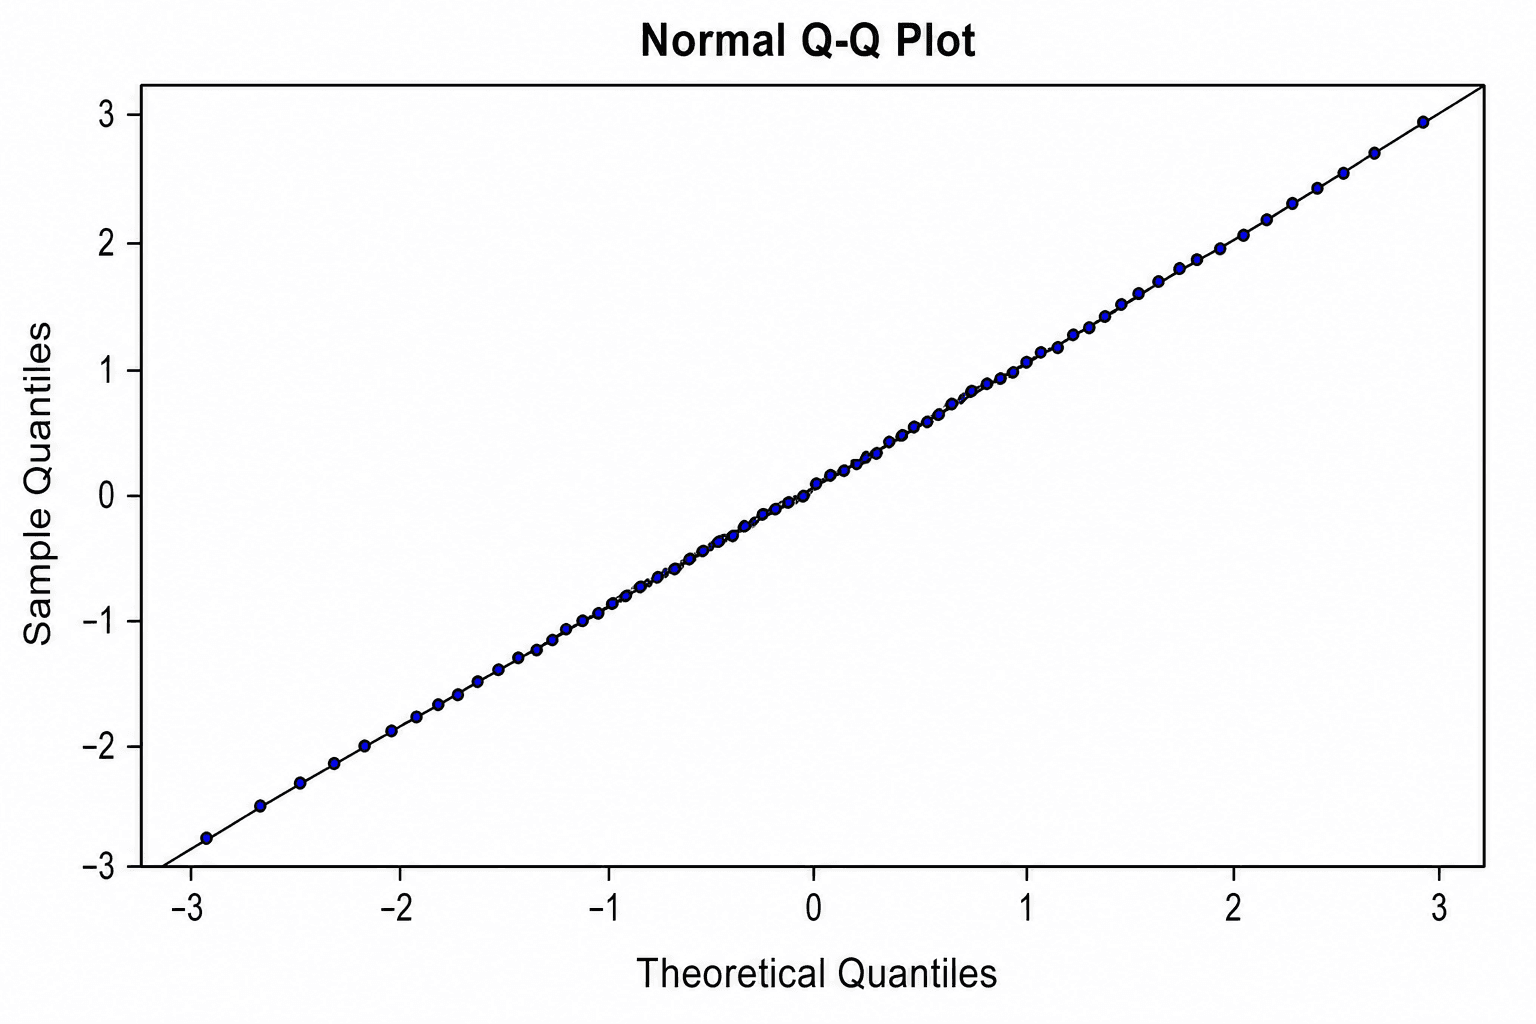
Q-Qプロット(Quantile-Quantile plot)は、データの分布を診断するためのツールであり、正規性の有無を「合格・不合格」で判定するような単純な検定ではありません。プロットされた点が基準線(対角線)に沿って並んでいれば、選択した理論分布とおおむね一致していることを示します。一方で、基準線からの乖離は、歪度(非対称性)、重い裾(ファットテール)、外れ値、データの従属性、丸め誤差、あるいは単にサンプルサイズが限定的であることなどを反映しています。重要なのは「すべての点が完全に直線上に並んでいるか」ではなく、「その乖離が、これから行う予定の解析手法において許容できるレベルかどうか」を判断することです。
SciDrawの Q-Q Plot Maker を使用すれば、CSVやExcelデータからこの診断プロットを簡単に作成し、さらに SciVis にシームレスに移行してグラフを美しく調整できます。プリセットされているサンプルには、正規分布への近似、重い裾、右に歪んだ分布、残差のプロット、2標本比較、そして信頼帯(信頼区間)付きのプロットなどが用意されています。
Q-Qプロットでよくある誤解と注意点
- 裾(テール)のわずかなブレを決定的な証拠と捉えてしまう: サンプルサイズが小さい場合、分布の両極端(裾の部分)は確率的に大きく変動します。
- 誤った理論分布を基準にしてしまう: 解析モデルが正規分布以外の分布を前提としている場合、正規Q-Qプロットが直線を描いているかどうかを確認すること自体に意味はありません。
- 基準線の定義(引き方)を無視してしまう: 四分位数を通る直線と、位置・尺度パラメータをフィッティングして引いた直線は同一ではありません。
- 孤立したプロット点をすぐに「エラー」と決めつける: データを分析から除外する前に、そのデータの由来やモデルへの影響度(インフルエンス)を十分に調査してください。
- プロットのみを厳密な検定として用いる: Q-Qプロットはモデル診断や専門的な知見に基づく判断を補完するものであり、それらを代替するものではありません。
Q-Qプロットに必要なデータ構成
ツールに用意されているサンプルデータでは、以下のように明示的な分位数カラムを使用しています。
| カラム名 | 役割 | データの具体例 |
|---|---|---|
quantile_rank | ソートされた順位位置 | 1 |
theoretical_quantile | 理論分布から期待される分位数 | -2.394 |
observed_quantile | ソートされた実際の観測値 | -2.1098 |
sample | 任意の系列ラベル(グループ名) | Sample A |
lower_95, upper_95 | 任意の信頼帯(信頼区間)の下限・上限値 | -3.036, -1.7519 |
実際のデータ構成については、正規分布適合のサンプルCSV や 信頼帯付きのサンプルCSV を参考にしてください。理論上の分位数は、解析で採用している確率の定義や基準となる理論分布と一致している必要があります。
ステップ 1:診断の目的を明確にする
観測値やモデルの残差を理論分布と比較したい場合は「1標本Q-Qプロット」を使用します。2つの異なる実データの分位数を直接比較したい場合は「2標本Q-Qプロット」を選択します。回帰分析の前提条件(残差の正規性など)を検証する場合は、生の目的変数ではなく、モデルをフィッティングした後に得られる「残差」をプロットしてください。
ステップ 2:CSVまたはExcelデータのアップロード
Q-Q Plot Maker を開き、サンプルデータを選択するか、お手持ちのCSV、TSV、TXT、XLSX、XLSファイルをアップロードします。Excelファイルの場合は最初のワークシートがインポートされます。アップロード後、分位数のカラムが数値型であり、一貫してソートされており、単位ラベルやコメント用のテキストが混入していないことを確認してください。
ステップ 3:プロットの生成とパターンの読み取り
まずはプロットの中央部分を確認し、その後に両端の裾(テール)に目を向けます。中央部分は直線に沿っているものの、両端にいくにつれて基準線から大きく離れていくようなパターンは、基準となる分布よりも裾が重い(または軽い)ことを示唆しています。また、全体が一方向に大きく湾曲している場合は、分布が左右非対称(歪んでいる)であることを示します。
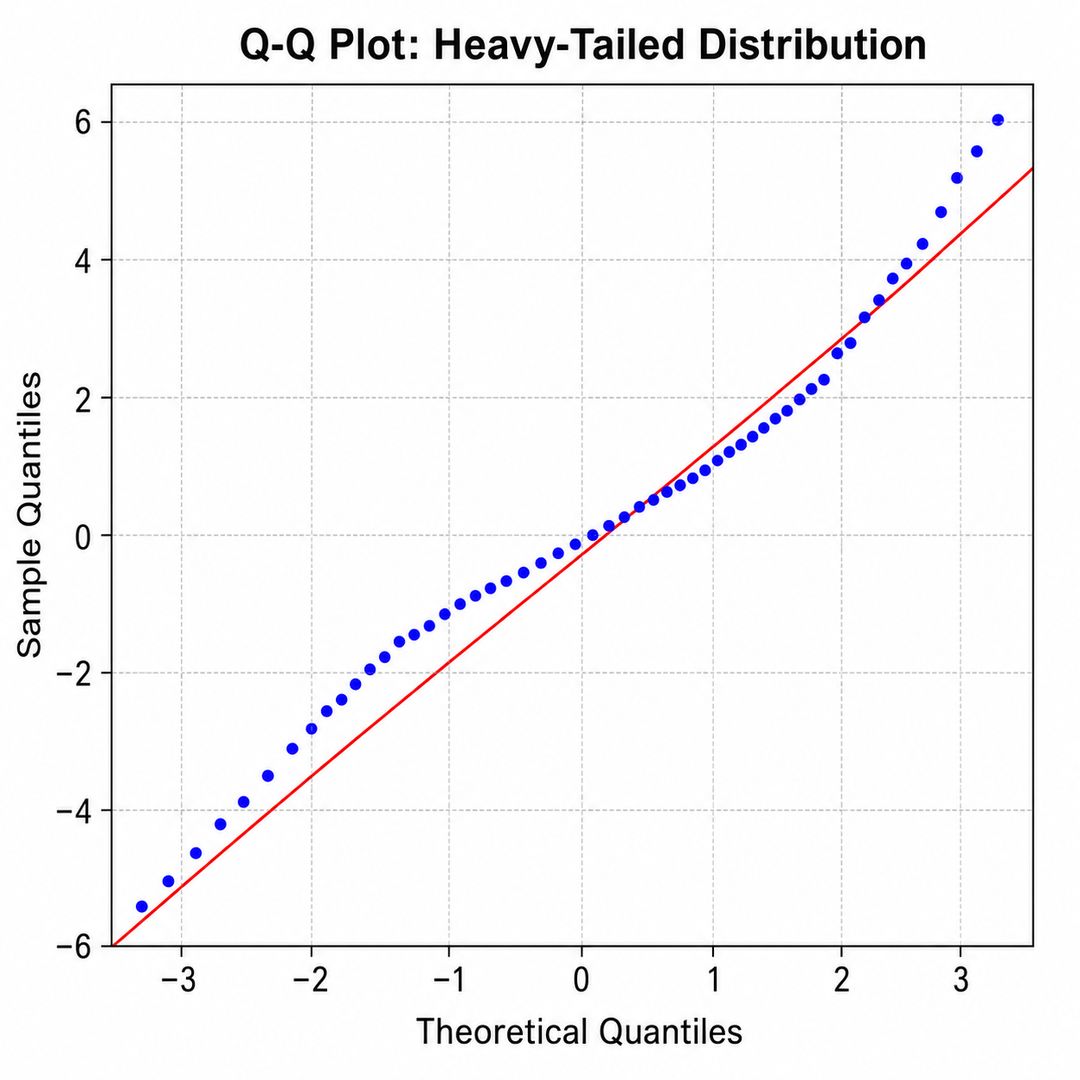
ただし、プロットの形状だけで原因を断定しないよう注意してください。外れ値の存在、複数グループの混在、データの従属性、あるいはモデル自体の誤設定(誤特定)によっても、同様のパターンが描かれることがあります。
ステップ 4:信頼帯の追加とコンテキストの整理
信頼帯(信頼区間)を表示することで、基準モデルにおいてサンプリングのばらつき(誤差)がどの程度許容されるかを視覚的に把握できます。信頼帯の外側にあるプロット点は詳しく調査する価値がありますが、この信頼帯は絶対的な基準ではありません。信頼帯の幅は、サンプルサイズ、推定方法、および設定した信頼水準によって変化します。
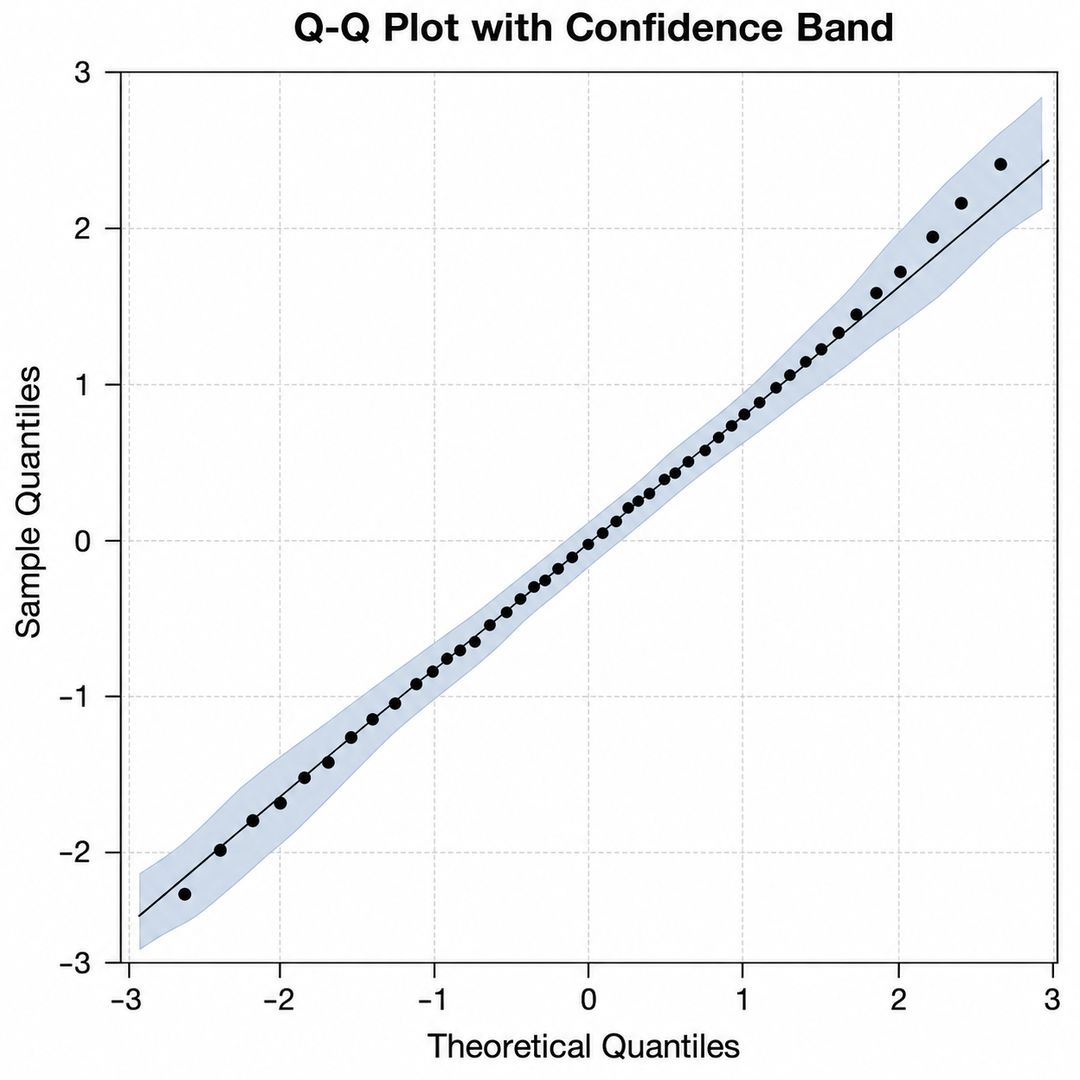
SciVisにデータを移行した後は、基準とした理論分布、サンプルサイズ、残差の算出元、信頼水準、そして注目すべき特異なプロット点に対するアノテーションなどを追加して、グラフのコンテキストを整理しましょう。複数のグループを同時に描画する場合は、軸のスケールを統一し、各系列を識別できる凡例を必ず配置してください。
代表的なQ-Qプロットの形状とその解釈
- プロットがほぼ直線上に並んでいる: 表示されている範囲において、サンプルデータは選択した基準分布と十分に適合していると考えられます。
- S字状に裾が乖離している: 乖離の方向に応じて、基準分布よりも裾が重い(ファットテール)、または裾が軽い分布であることを示しています。
- 全体的に上または下に一貫して湾曲している: データ分布が左右に歪んでいる(非対称である)可能性があります。
- 1点または数点だけが大きく離れている: 外れ値の可能性、データ入力エラー、あるいはモデルに強い影響を与えている特異なデータ点(強影響点)がないか調査してください。
- 傾きや切片が基準線と異なる: 位置(平均など)や尺度(分散など)が異なっています。2標本Q-Qプロットにおいてこの現象が起きた場合、2つの分布の形状自体は似ているものの、中心位置やデータの広がりが異なっていることを意味します。
プロットを解釈する際は、サンプルサイズ、データの収集デザイン、データ変換の有無、モデル残差の診断結果、そして適用予定の統計手法の特性などを総合的に考慮してください。
Q-Qプロットと正規性検定の使い分け
Q-Qプロットは、データの分布が基準分布から「どこで、どのように」乖離しているかを視覚的に示してくれます。一方で、形式的な統計的検定(シャピロ・ウィルク検定など)は、分布の適合度を単一の統計量やp値という数値に凝縮して判定します。しかし、検定はサンプルサイズが小さいと検出力が不足し、逆にサンプルサイズが極めて大きいと、実用上問題のない極めてわずかなズレに対しても過敏に「非正規である」と判定してしまう欠点があります。そのため、状況に応じて両者を併用し、観察された乖離が解析手法の頑健性(ロバストネス)の許容範囲内であるかどうかを評価することが推奨されます。
なお、データそのものの生の分布形状を確認したい場合は、Histogram Maker(ヒストグラム)、Density Plot Maker(確率密度プロット)、または ECDF Plot Generator(経験累積分布関数プロット)を併用すると、より多角的な視点からデータを把握できます。
よくある質問(FAQ)
Q-Qプロットが直線になれば、データが正規分布に従っていると証明できますか?
いいえ。あくまで「手元にあるサンプルサイズの範囲内において、視覚的に正規分布と矛盾しないこと」を示しているに過ぎず、母集団が完全に正規分布に従っていることを厳密に証明することはできません。
信頼帯の外側にあるプロット点は、データから削除すべきですか?
いいえ、安易に削除してはいけません。まずはそのデータがどこから生じたのか、そして解析結果にどのような影響を与えているかを調査してください。データを除外するには、単に「グラフの見栄えが悪いから」という理由ではなく、明確で説明可能なルールや、データ品質上の裏付けとなる理由が必要です。
モデルの残差に対してQ-Qプロットを使用できますか?
はい。残差のQ-Qプロットは非常によく使われる診断方法です。ただし、正規性はモデル診断における一側面に過ぎません。必要に応じて、残差のプロットパターン、不均一分散性、自己相関(独立性)、レバレッジ(影響度)、およびモデルの定式化が適切かどうかも併せて確認してください。
2つの実データを直接比較することは可能ですか?
はい、可能です。「2標本Q-Qプロット」を使用することで、2つの実データ群から得られた対応する分位数を直接比較できます。プロットが直線に近ければ2つの分布形状が類似していることを示し、その直線の傾きや切片のズレは、両者の尺度(ばらつき)や位置(平均)の違いを反映します。
データの視覚的診断を始めましょう
まずは Q-Q Plot Maker にデータを読み込み、基準となる理論分布を明示することから始めましょう。さらに説得力のあるグラフを作成するために、学術データ可視化ガイド を参考にして、分布を補完する他のチャートも組み合わせてみてください。