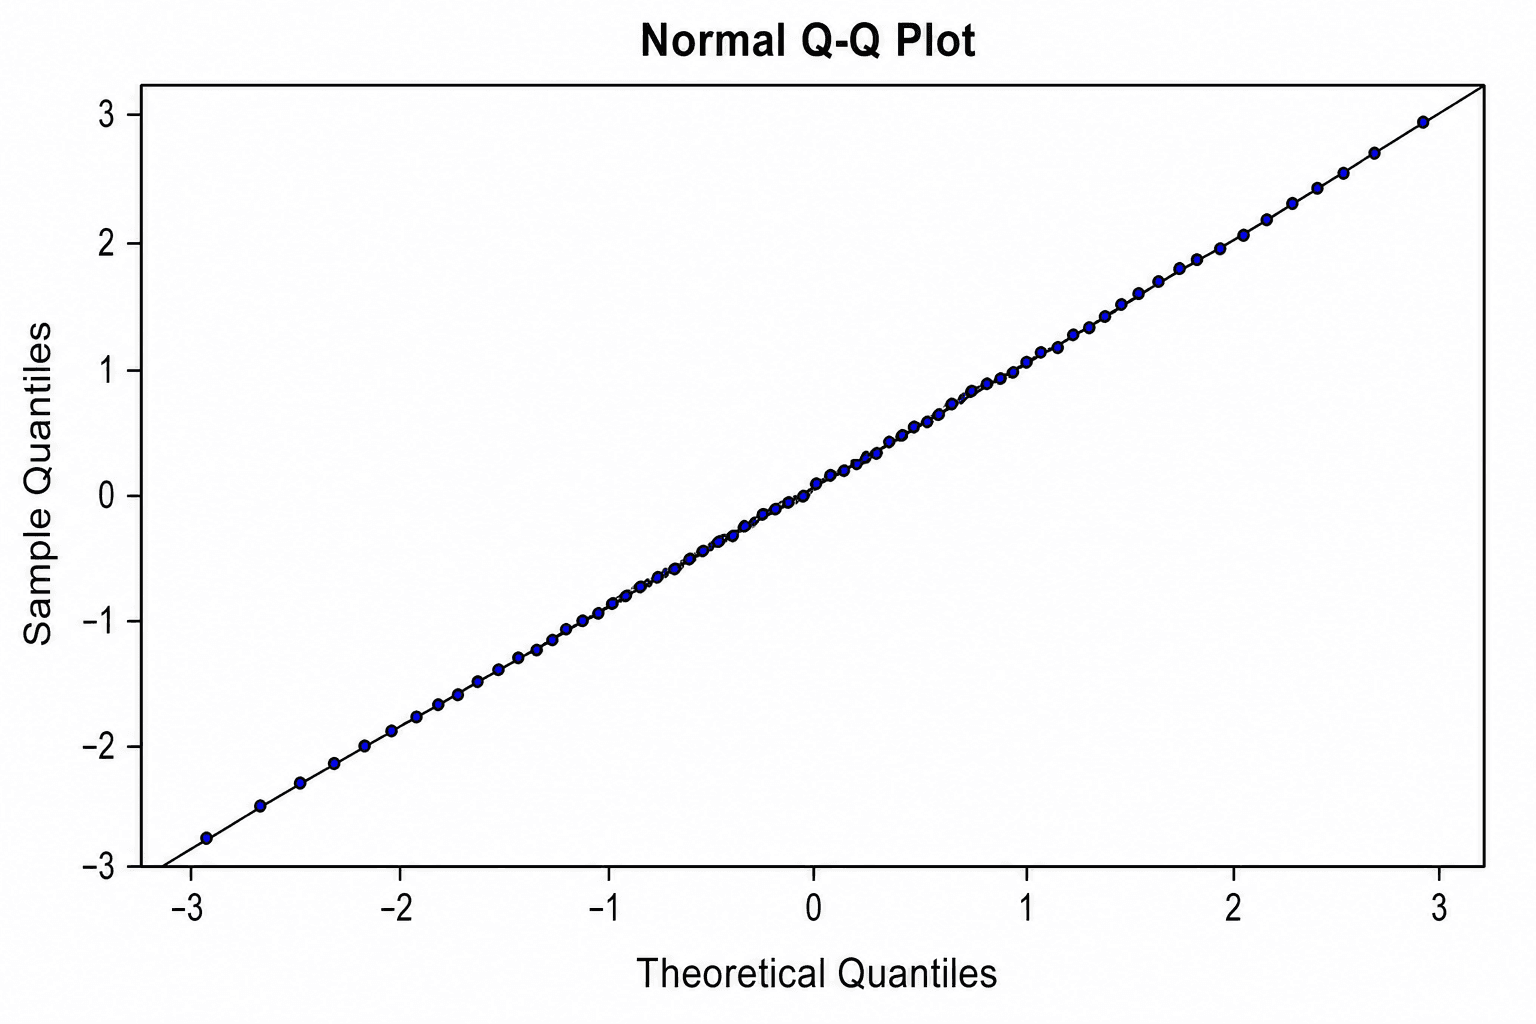
在数据分析中,Q-Q 图(Quantile-Quantile Plot,分位数-分位数图)是一种探索性的诊断工具,而非判别数据是否绝对正态的“非黑即白”合格证书。当图中的数据点紧密围绕参考线分布时,表明样本数据与所选的理论分布大致吻合;而一旦数据点偏离参考线,则可能反映出数据存在偏度(Skewness)、重尾(Heavy tails)、异常值、相关性、舍入误差,或者仅仅是因为样本量有限。在实际科研中,我们不必苛求每一个数据点都完美地排成一条直线,更有价值的思考在于:这种偏差是否会实质性地影响您后续拟合模型或统计推断的有效性?
SciDraw 的 Q-Q 图在线生成器(Q-Q Plot Maker) 支持直接导入 CSV 或 Excel 数据快速生成诊断图,并能一键导入 SciVis 可视化编辑器 进行深度美化与定制。我们为您提供了多种经典场景的内置示例,包括:近似正态分布、重尾分布、右偏分布、残差分析、双样本对比以及带置信带的 Q-Q 图。
绘制与解读 Q-Q 图的常见误区
- 过度解读尾部的轻微波动: 在小样本中,极端值(尾部数据)本身就具有极大的随机波动性。
- 套用错误的理论分布: 如果您的统计模型假设数据服从其他分布,那么强行绘制一条正态分布的 Q-Q 直线是毫无意义的。
- 混淆参考线的定义: 基于四分位数绘制的参考线与基于拟合位置-尺度参数(Location-Scale)绘制的参考线在数学定义上并不等同。
- 盲目将孤立的偏离点判定为异常值: 在剔除任何数据点之前,必须严格追溯其数据来源并评估其对模型的实际影响力。
- 将 Q-Q 图视作绝对的假设检验: Q-Q 图是直观的辅助诊断工具,它应当与模型诊断指标、专业领域经验相结合,而不是完全取代形式化的统计检验。
绘制 Q-Q 图需要什么格式的数据?
我们的在线工具内置了直观的示例,数据中包含明确的分位数列表:
| 列名 | 作用说明 | 数据示例 |
|---|---|---|
quantile_rank | 排序后的位置序号 | 1 |
theoretical_quantile | 理论分布下的预期分位数 | -2.394 |
observed_quantile | 实测样本排序后的分位数 | -2.1098 |
sample | 样本分组或系列标签(可选) | Sample A |
lower_95, upper_95 | 95% 置信区间上下界(可选) | -3.036, -1.7519 |
您可以直接下载并参考我们的 正态拟合示例 CSV 或 带置信带示例 CSV。请确保您计算的理论分位数与您研究所采用的概率计算约定及参考分布完全一致。
第一步:明确您的统计诊断目的
- 单样本 Q-Q 图: 用于将实测观测值或模型残差与某一特定的理论分布(如标准正态分布)进行对比。
- 双样本 Q-Q 图: 用于直接对比两个经验样本的分位数分布,观察两组数据的分布形态是否一致。
- 回归假设检验: 如果您正在检验线性回归模型的假设前提,请务必绘制**模型拟合后产生的残差(Residuals)**的 Q-Q 图,而非直接绘制原始因变量的 Q-Q 图。
第二步:上传您的 CSV 或 Excel 数据
打开 Q-Q 图在线生成器,您可以直接选择一个内置示例,或上传您自己的数据文件(支持 CSV、TSV、TXT、XLSX 或 XLS 格式)。如果上传的是 Excel 文件,系统默认导入第一个工作表(Worksheet)。请确保分位数数据列全部为数值型、排序方向一致,且不包含任何单位符号或注释文本。
第三步:生成图表并解读分布模式
解读 Q-Q 图时,应遵循“先中间、后两头”的原则。首先观察中部数据点的贴合情况,再观察两端的尾部变化。如果数据在中间高度贴合,但在两端逐渐偏离参考线,通常意味着实际数据的尾部比理论分布更重(厚尾)或更轻(薄尾)。如果数据点呈现出系统性的单侧弯曲,则通常预示着数据存在偏态。
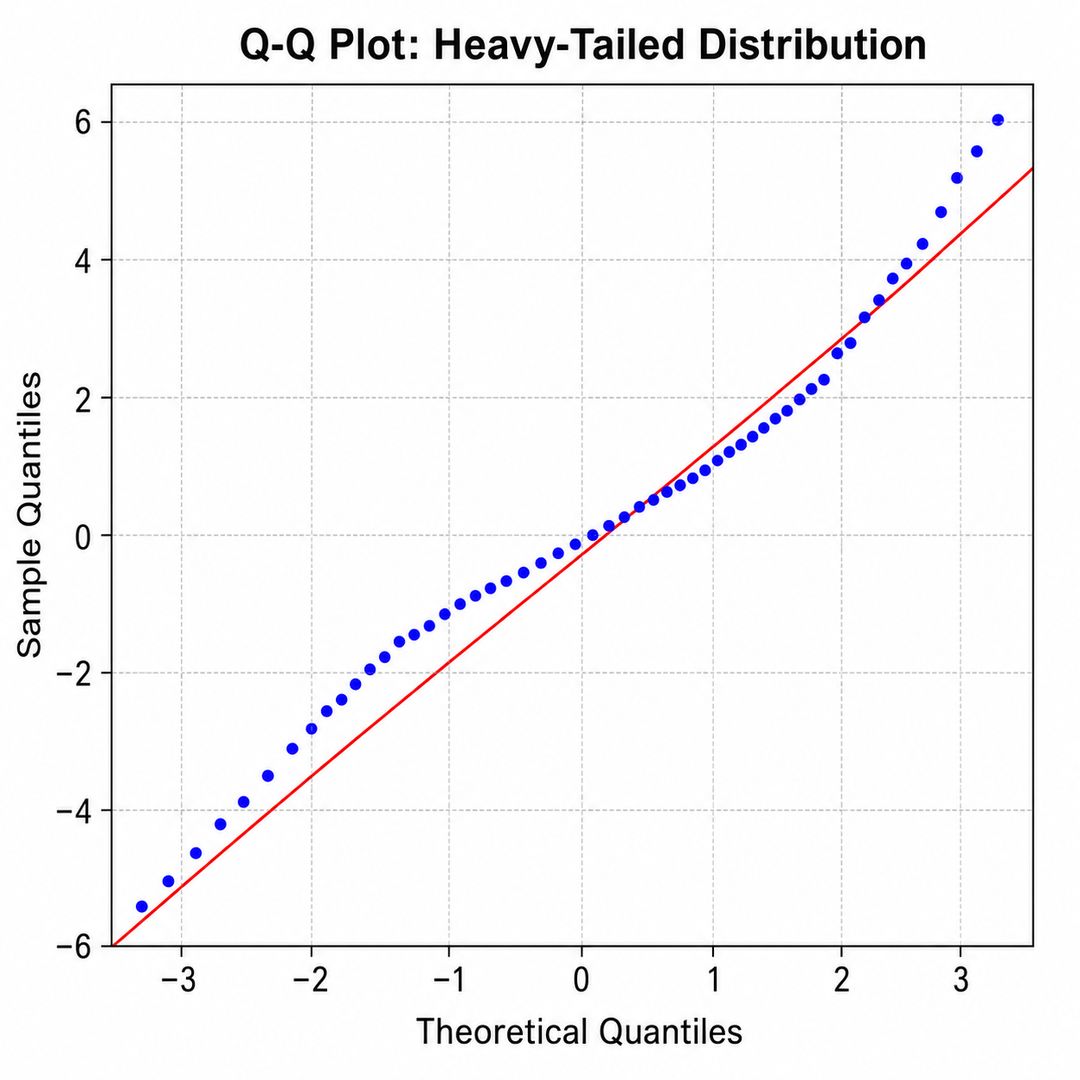
需要注意的是,切勿仅凭图形形状就草率断定其背后的物理成因。类似的偏离轨迹可能由多种因素共同导致,例如存在极端异常值、混合总体、数据间存在相关性,或是模型设定本身存在偏差。
第四步:添加置信区间与上下文信息
引入置信带(Confidence Envelope)可以为评估抽样波动提供直观的视觉参考范围。落在置信带之外的数据点值得重点关注,但请注意,置信带并非一成不变:其宽度高度取决于样本量的大小、参数估计方法以及所选的置信水平。
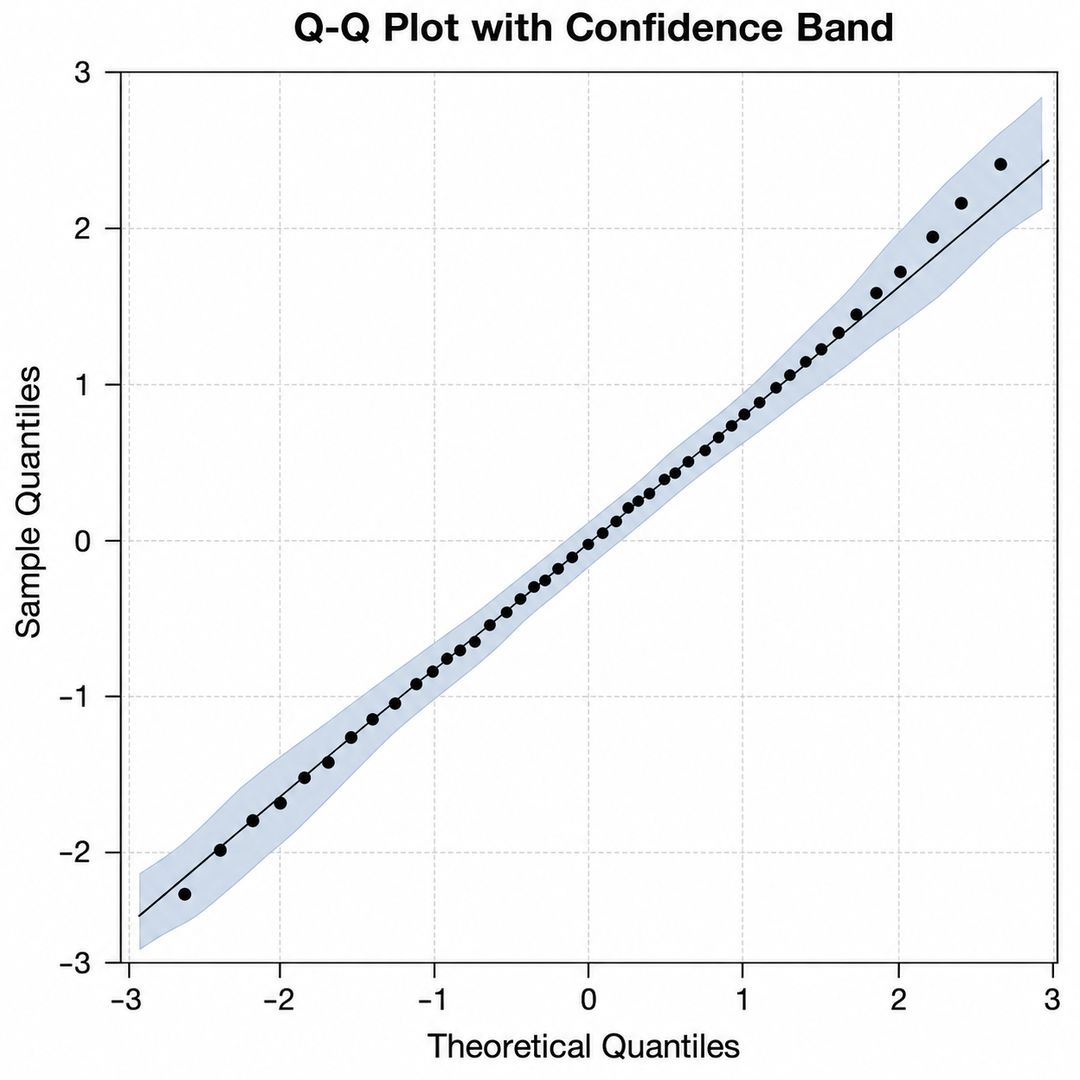
点击进入 SciVis 编辑器,您可以为图表添加详细的学术标注,如参考分布类型、样本量、残差来源、置信水平以及关键观测点的标注。如果在一张图内展示了多个数据组,请保持坐标轴刻度一致,并使用图例清晰区分每一个数据系列。
常见 Q-Q 图形态的学术解读指南
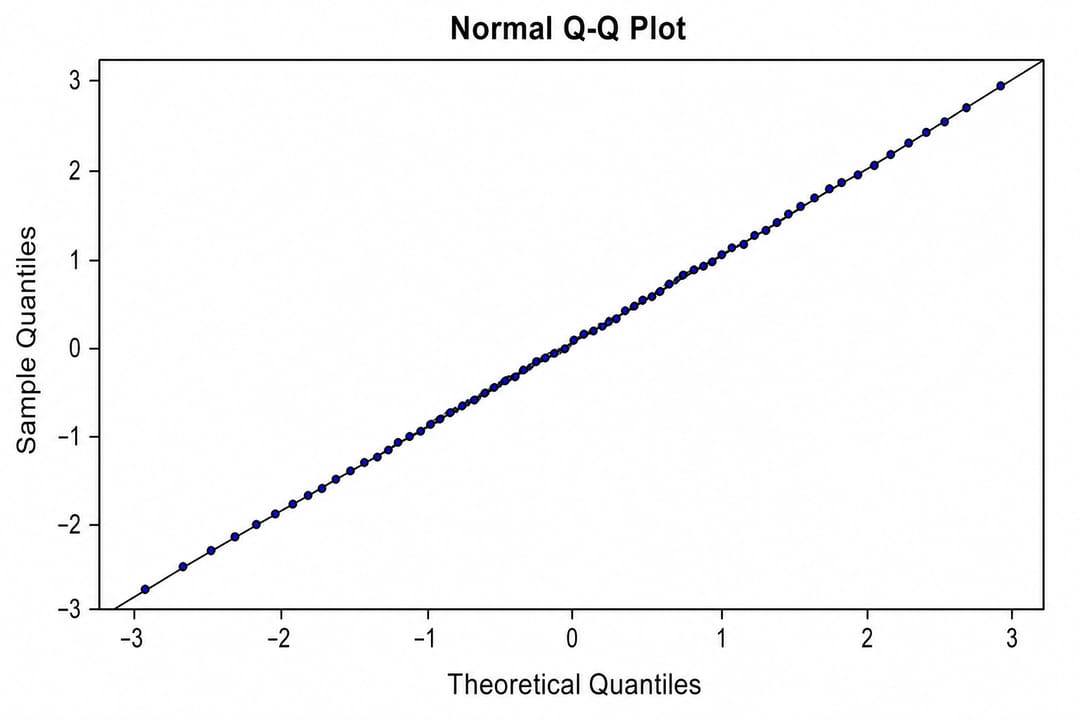
- 数据点基本呈一直线: 样本数据在当前观测区间内与所选的理论参考分布高度契合。
- 数据点呈 S 形偏离(两端翘起或下塌): 表明样本数据相比于理论分布存在更重(厚尾)或更轻(薄尾)的尾部特征。
- 数据点呈现持续向上或向下的弧形弯曲: 表明样本数据存在明显的左偏或右偏(偏度问题)。
- 极少数孤立点严重偏离: 提示可能存在潜在的极端值、录入错误或对模型有显著影响的强影响点。
- 斜率或截距发生偏移: 说明两者的位置参数(均值)或尺度参数(标准差)存在差异。在双样本 Q-Q 图中,这代表两组数据的分布形状相似,但中心位置或离散程度不同。
在撰写论文时,请务必结合样本量大小、实验设计方案、数据变换方式、模型残差诊断以及您计划采用的统计分析方法,进行综合、客观的论证。
应该选择 Q-Q 图还是正态性检验?
Q-Q 图的优势在于能够直观地展示数据在何处以及如何偏离参考分布。而传统的假设检验(如 Shapiro-Wilk 检验)会将所有信息压缩为一个单一的统计量和 p 值——这往往导致在小样本时检验效能不足(无法发现明显的非正态),而在大样本时又过于敏感(微小的偏差也会报出极显著的 p 值)。因此,推荐将两者结合使用,并重点评估观测到的实际偏差是否会动摇您拟采用的统计方法的稳健性。
如果您想更直观地观察原始数据的分布轮廓,配合使用 直方图生成器(Histogram Maker)、核密度估计图生成器(Density Plot Maker) 或 经验累积分布函数图生成器(ECDF Plot Generator) 将会提供更全面的互补视角。
常见问题解答 (FAQ)
Q-Q 图呈一条直线,能证明我的数据绝对服从正态分布吗?
不能。它仅代表在当前的样本量下,您的样本数据与正态分布在视觉上是高度兼容的,但无法在数学上绝对证明总体完全服从正态分布。
我应该直接删掉落在置信带之外的数据点吗?
不建议这样做。您应当首先排查这些数据点的来源并评估其对分析结果的实际影响。剔除数据必须基于严谨、可辩驳的学术规则或明确的数据质量缺陷记录,而不能仅仅为了让图表看起来更美观。
Q-Q 图可以用于分析模型的残差吗?
当然可以。残差 Q-Q 图是回归分析中最常用的诊断手段之一。但请记住,正态性只是模型诊断的其中一个维度,您通常还需要同步考察残差的拟合模式、异方差性、独立性、杠杆值以及模型设定是否合理。
我可以直接用它对比两个不同的样本组吗?
可以。双样本 Q-Q 图通过直接对比两组数据的经验分位数来工作。如果数据点紧贴对角线,说明两组数据的分布形状高度相似;而直线的斜率和截距则分别反映了它们在尺度(离散度)和位置(均值)上的差异。
立即开始绘制
欢迎使用 Q-Q 图在线生成器(Q-Q Plot Maker) 开启您的数据诊断。在完成初步绘制后,您可以参考我们的 科研数据可视化指南,为您的学术论文搭配更丰富的多维度分布图表。