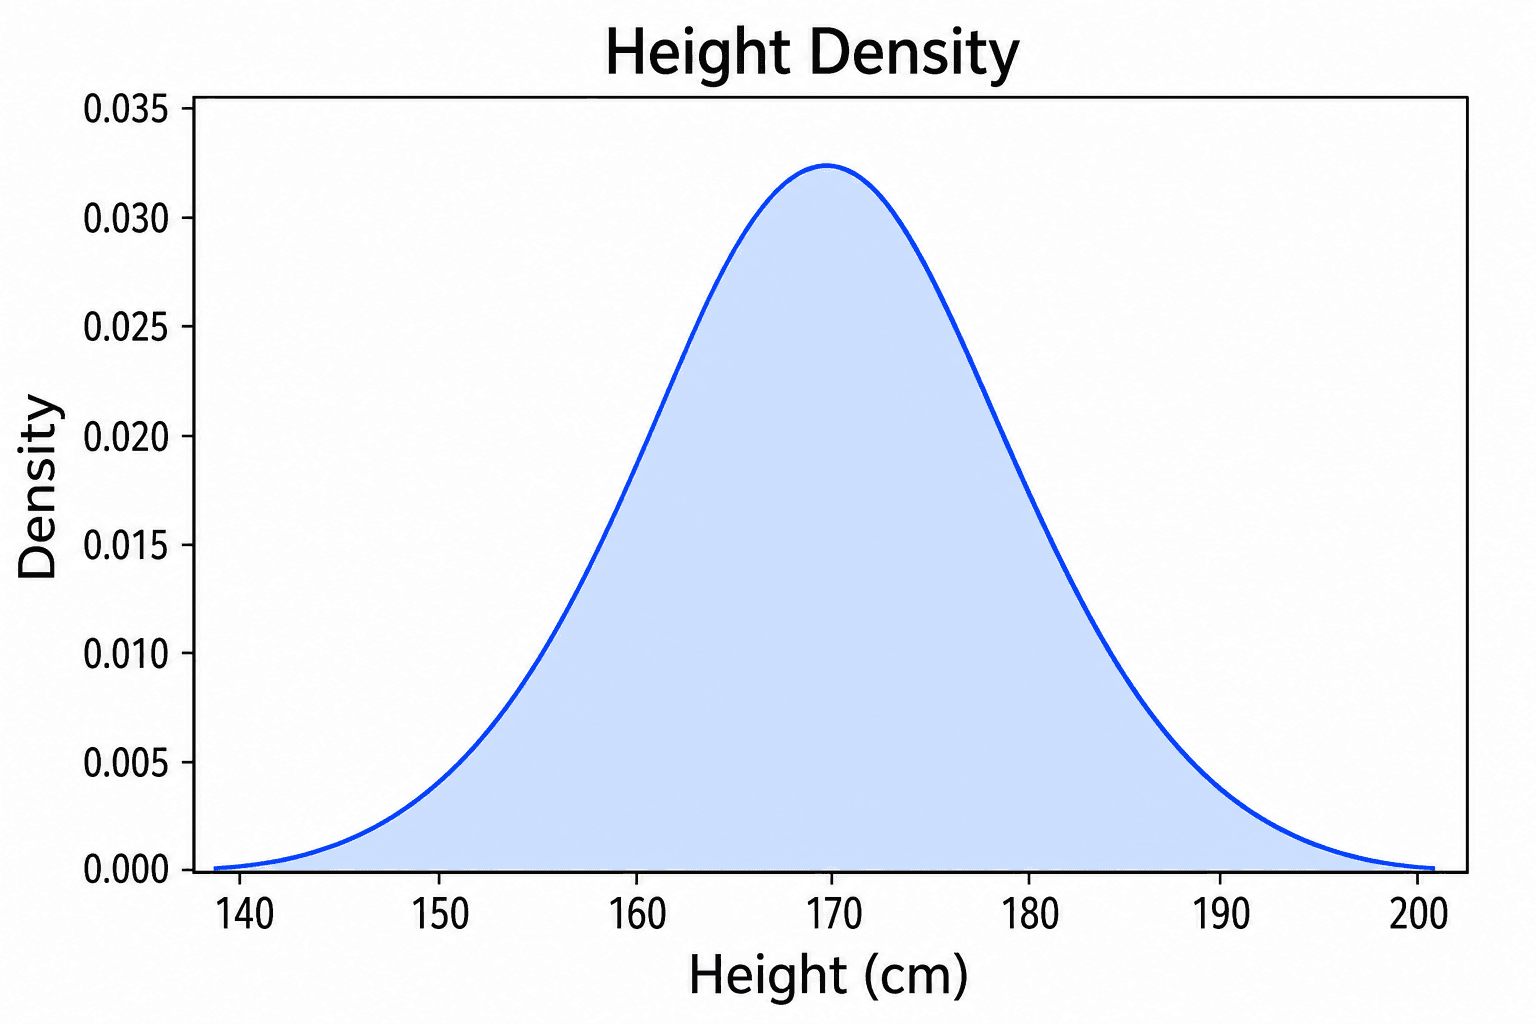
一条平滑的密度曲线,在展现数据特征的同时,也可能带来误导。过度平滑会抹平本就存在的亚群结构,而平滑不足则会将随机抽样误差放大为一连串虚假的“波峰”。因此,绘制一张具有学术说服力的核密度图,不仅需要干净的原始观测数据,还需要仔细校验曲线形态在不同参数下的稳定性。
SciDraw 的核密度图生成器(Density Plot Maker)能够直接读取 CSV 或 Excel 表格,自动计算核密度估计(KDE),并将其无缝导入 SciVis 可视化编辑器中进行后期排版。我们提供了六种经典的示例数据集,涵盖单组、多组对比、偏态分布、双峰分布、直方图叠加以及山脊图(ridgeline)等多种常见科研场景。
核密度图的常见误区
- 将“密度”等同于“频数”: y 轴代表的是估计的概率密度,而非绝对频数。在标准状态下,曲线下方的总面积积分为一。
- 忽视带宽(Bandwidth)的影响: 带宽直接决定了曲线的平滑程度。带宽选择不当会人为改变图表中波峰的数量。
- 在不同尺度上对比分组: 对比多组数据时,必须确保数据转换方式(如对数转换)和物理单位完全一致。
- 样本量过小时强行拟合: 平滑的曲线容易给读者造成“样本量充足”的错觉。如果数据点稀疏,拟合曲线往往缺乏统计学支撑。
- 截断尾部数据: 盲目裁剪 x 轴的显示范围可能会掩盖极端值,而这些异常值在临床或工程实验中往往具有重要意义。
核密度图需要什么格式的数据?
请准备长格式(Long-format)表格,确保每行仅包含一个观测值:
| 列名 | 作用 | 示例数据 |
|---|---|---|
sample_id | 样本唯一标识符(可选) | Control_01 |
group | 分组变量(可选,用于多组对比) | Control |
value | 观测数值(必填) | 38.92 |
您可以参考我们的单组密度图 CSV 模板或多组对比 CSV 模板。请注意,数值单元格内不要混入单位符号,缺失值需使用统一的格式表示。
第一步:评估数据是否适合进行平滑拟合
核密度图最适合用于展示连续型变量,且样本量需足够大,以支撑起合理的分布估计。如果您的数据是离散的计数数据且取值较少,使用直方图、经验累积分布函数图(ECDF)或散点图会更加真实。若样本量较小,建议叠加原始数据点,或直接使用蜂群图生成器(Beeswarm Plot Maker)。
第二步:上传 CSV 或 Excel 数据
进入核密度图生成器,您可以直接选用内置的示例,也可以上传自己的 CSV、TSV、TXT、XLSX 或 XLS 文件。若上传 Excel 文件,系统默认读取第一个工作表(Worksheet)。请确保待分析的数值列已被正确识别为数值格式,且分组名称中没有因拼写错误导致的重复分组。
第三步:生成曲线并微调带宽
系统初始生成的曲线仅是一个基于算法的初步估计,并不代表真实的底层分布。建议手动调大和调小带宽进行对比观察。如果数据中确实存在某种分布特征(如双峰),那么在合理的带宽区间内,该特征应当是稳定存在的;如果某个波峰仅在极端的窄带宽下出现,则不应将其作为科学结论的依据。
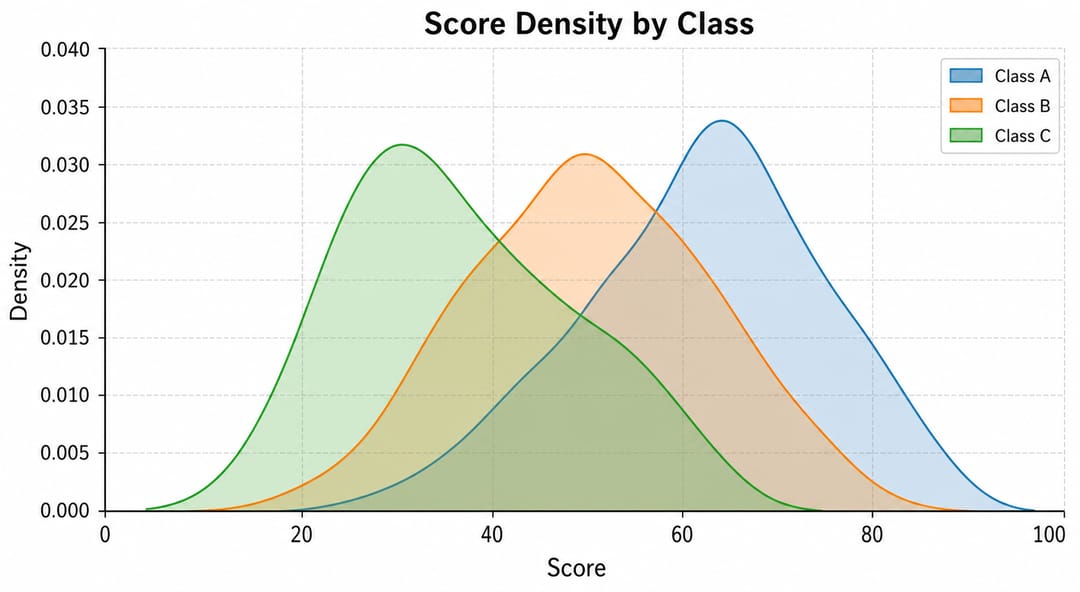
当多组曲线发生重叠时,建议使用半透明填充色或区分度明显的轮廓线。同时,同一张图表中的对比分组不宜过多。考虑到纸质打印或色觉障碍读者的阅读体验,请避免单纯依赖颜色来区分不同分组。
第四步:在 SciVis 中完善图表细节
点击进入编辑器,您可以修改坐标轴标题、图例名称、配色方案、添加文本标注并调整版面布局。在密度图下方叠加地毯图(Rug plot)或直方图,能够直观地呈现原始数据点的分布位置,帮助读者判断曲线的起伏究竟是由真实数据支撑,还是平滑算法产生的伪影。
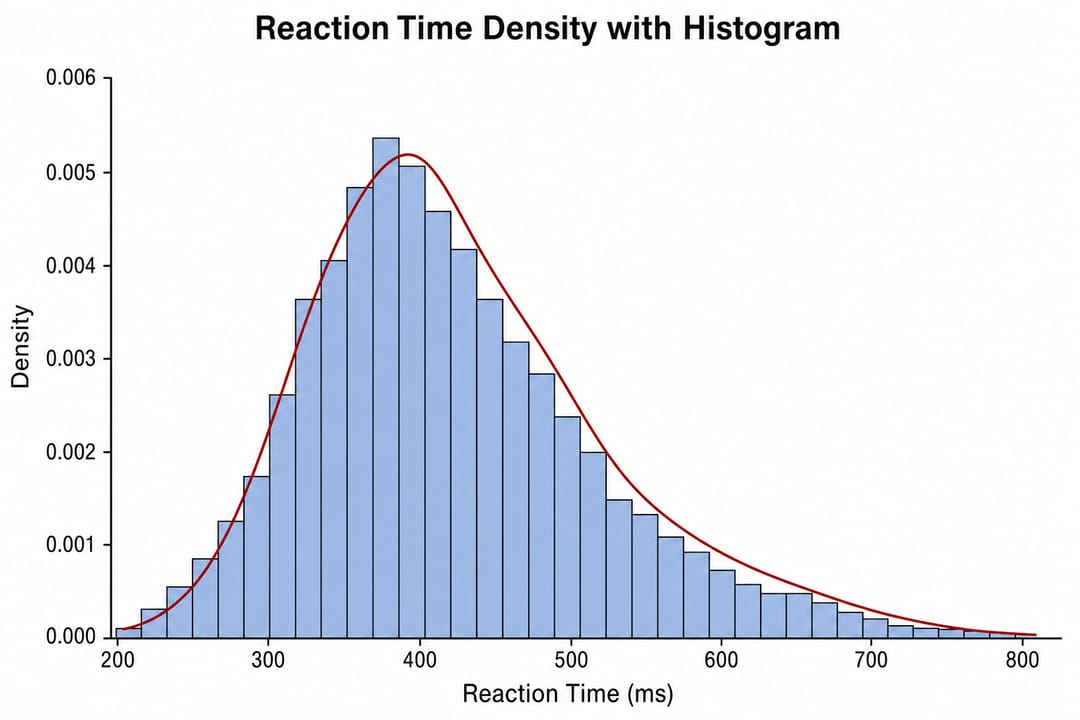
如果对数据进行了对数(Log)等数学转换,请在图表中明确注明。若需要剔除异常值,请在数据清洗阶段进行可重复的操作,切忌直接在图表编辑器中手动删除“不符合预期”的数据点。
如何解读核密度图
核密度图的 x 轴代表测量的数值,y 轴的曲线高度代表数据点在该数值附近的相对密集程度。通过对比不同分组曲线的位置(均值)、跨度(方差)、偏度以及尾部形态,可以直观评估组间差异。需要注意的是,由于核密度图经过了归一化处理,两条高度相同的曲线并不意味着两组的样本量相同。
只有在曲线经过严格归一化、且模型假设成立的前提下,曲线下方特定 x 区间内的面积才代表该区间内的样本比例估计值。
密度图、直方图、ECDF 图还是小提琴图?
- 如果您需要展示每个区间内具体的频数或样本数,请使用直方图生成器(Histogram Maker)。
- 如果您希望展示无损的完整分布,且不想受到带宽选择的主观干扰,请使用ECDF 曲线生成器(ECDF Plot Generator)。
- 如果需要并排对比大量分组的分布特征,请使用空间利用率更高的小提琴图生成器(Violin Plot Maker)。
- 如果您的核心目的是展示平滑的分布轮廓,或进行少数几组数据的重叠对比,核密度图是最佳选择。
常见问题
不写 Python 或 R 代码能画核密度图吗?
可以。您只需将数据上传至核密度图生成器,一键生成后即可在 SciVis 交互式界面中完成所有细节微调。
y 轴的数值代表什么意思?
y 轴代表概率密度,而非样本个数。当 x 轴的取值范围非常窄时,y 轴的密度值完全可能大于一。在核密度图中,曲线下方的面积才是具有统计学意义的量。
如何选择合适的带宽(Bandwidth)?
建议先采用系统默认的自动带宽算法,然后在其上下微调。选择一个既能展现数据主要结构、又不会引入过多随机噪声的平滑度。如果分布形状是您论文的核心论据,请在方法学部分注明所使用的带宽计算方法。
样本量不同的分组可以放在一起对比密度吗?
可以。归一化后的密度曲线对比的是分布的“形状”,但它会隐去样本量差异的信息。如果样本量差异对结论有影响,请在图表中注明各组的 $N$ 值,或在图表下方叠加原始数据点。
开始绘制
立即打开核密度图生成器导入您的数据。在绘图过程中,请务必对照原始数据点校验平滑曲线的真实性。如果您发现平滑拟合不适用于当前数据,可以参考我们的科研数据可视化指南选择更合适的图表类型。