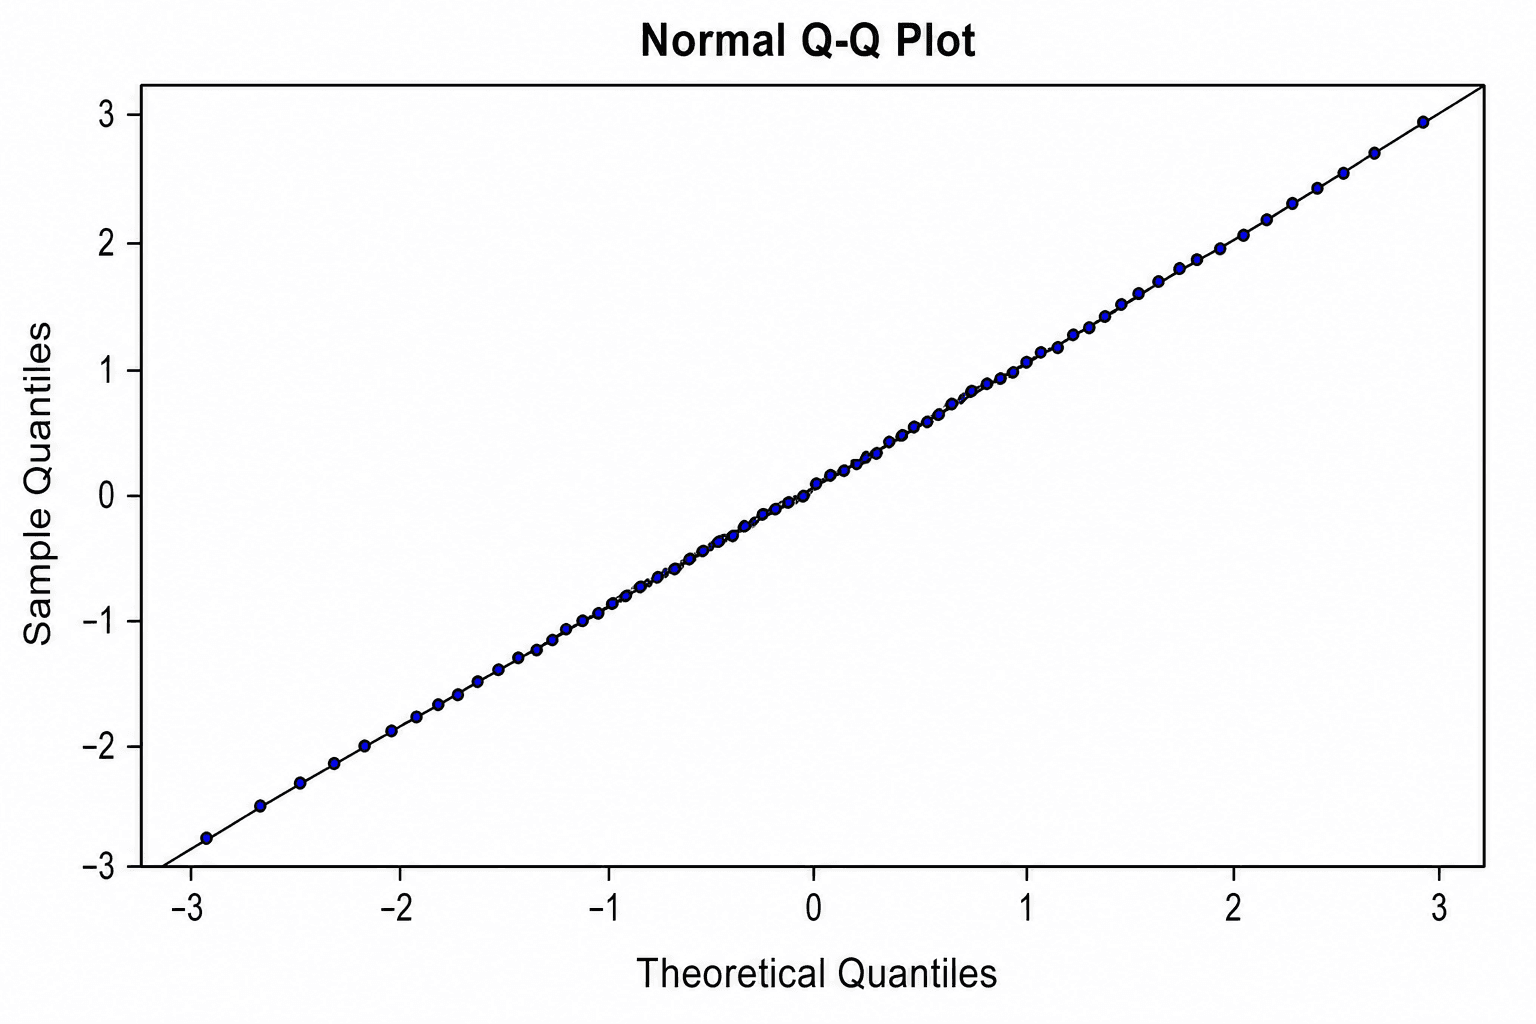
Un grafico Q-Q (Quantile-Quantile plot) è uno strumento diagnostico qualitativo, non un test di ipotesi formale con esito binario per decretare la normalità di una distribuzione. La disposizione dei punti lungo la retta di riferimento indica una sostanziale concordanza con la distribuzione teorica assunta; eventuali scostamenti possono riflettere asimmetria (skewness), code pesanti, presenza di outlier, dipendenza statistica, arrotondamenti dei dati o, molto semplicemente, le limitazioni intrinseche di un campione di dimensioni ridotte. La domanda corretta da porsi non è se ogni singolo punto sia perfettamente allineato alla diagonale, ma se la deviazione riscontrata sia tale da compromettere la validità dell'analisi statistica pianificata.
Il Q-Q Plot Maker di SciDraw consente di generare questo grafico diagnostico a partire da file CSV o Excel, per poi aprirlo direttamente in SciVis per la formattazione finale. Tra i modelli preimpostati sono disponibili esempi di approssimazione alla distribuzione normale, code pesanti, asimmetria positiva (a destra), analisi dei residui, confronto a due campioni e bande di confidenza.
Errori comuni nell'uso dei grafici Q-Q
- Considerare decisivo il rumore di fondo sulle code: nei piccoli campioni, i valori estremi presentano una variabilità intrinseca molto elevata.
- Utilizzare una distribuzione teorica di riferimento errata: un grafico Q-Q lineare rispetto alla normale è del tutto irrilevante se il modello statistico ipotizza una distribuzione differente.
- Ignorare la definizione della retta di riferimento: le rette passanti per i quartili e le rette stimate sui parametri di posizione e scala (fitted-location-scale) non coincidono.
- Etichettare immediatamente un punto isolato come errore di misura: prima di escludere qualsiasi dato, è fondamentale indagarne l'origine e l'effettivo indice di influenza.
- Sostituire i test formali con la sola valutazione visiva: il grafico Q-Q affianca e integra la diagnostica dei modelli e le competenze di dominio, ma non le sostituisce.
Struttura dei dati richiesti per un grafico Q-Q
I modelli di esempio inclusi nella piattaforma utilizzano colonne esplicite per i quantili:
| Colonna | Funzione | Esempio |
|---|---|---|
quantile_rank | Posizione ordinata | 1 |
theoretical_quantile | Quantile atteso secondo la distribuzione teorica | -2.394 |
observed_quantile | Valore osservato ordinato | -2.1098 |
sample | Etichetta opzionale della serie | Sample A |
lower_95, upper_95 | Limiti opzionali dell'inviluppo di confidenza | -3.036, -1.7519 |
È possibile esaminare la struttura scaricando il CSV di esempio per il fit normale o il CSV di esempio con banda di confidenza. I quantili teorici devono essere calcolati in coerenza con le convenzioni di probabilità e la distribuzione di riferimento adottate nello studio.
Passo 1: Definire l'obiettivo della diagnostica
Si utilizzi un grafico Q-Q a campione singolo per confrontare i valori osservati o i residui di un modello con una distribuzione teorica nota. Si ricorra invece a un grafico Q-Q a due campioni per confrontare direttamente i quantili di due distribuzioni empiriche. Se l'obiettivo è verificare gli assunti di un modello di regressione, si traccino i residui generati dal modello stimato e non i valori grezzi della variabile risposta.
Passo 2: Caricare i dati in formato CSV o Excel
Accedere al Q-Q Plot Maker, selezionare uno dei modelli preimpostati o caricare un file in formato CSV, TSV, TXT, XLSX o XLS. In caso di file Excel, la piattaforma importerà automaticamente il primo foglio di lavoro. Verificare che le colonne dei quantili contengano esclusivamente valori numerici ordinati in modo coerente, privi di unità di misura o annotazioni testuali.
Passo 3: Generare e interpretare il grafico
L'analisi visiva deve concentrarsi inizialmente sulla parte centrale della distribuzione, per poi spostarsi verso le code. Un buon allineamento al centro che decade in scostamenti progressivi alle due estremità suggerisce la presenza di code più pesanti (heavy tails) o più leggere rispetto alla distribuzione teorica di riferimento. Una curvatura sistematica e unidirezionale indica generalmente un'asimmetria della distribuzione.
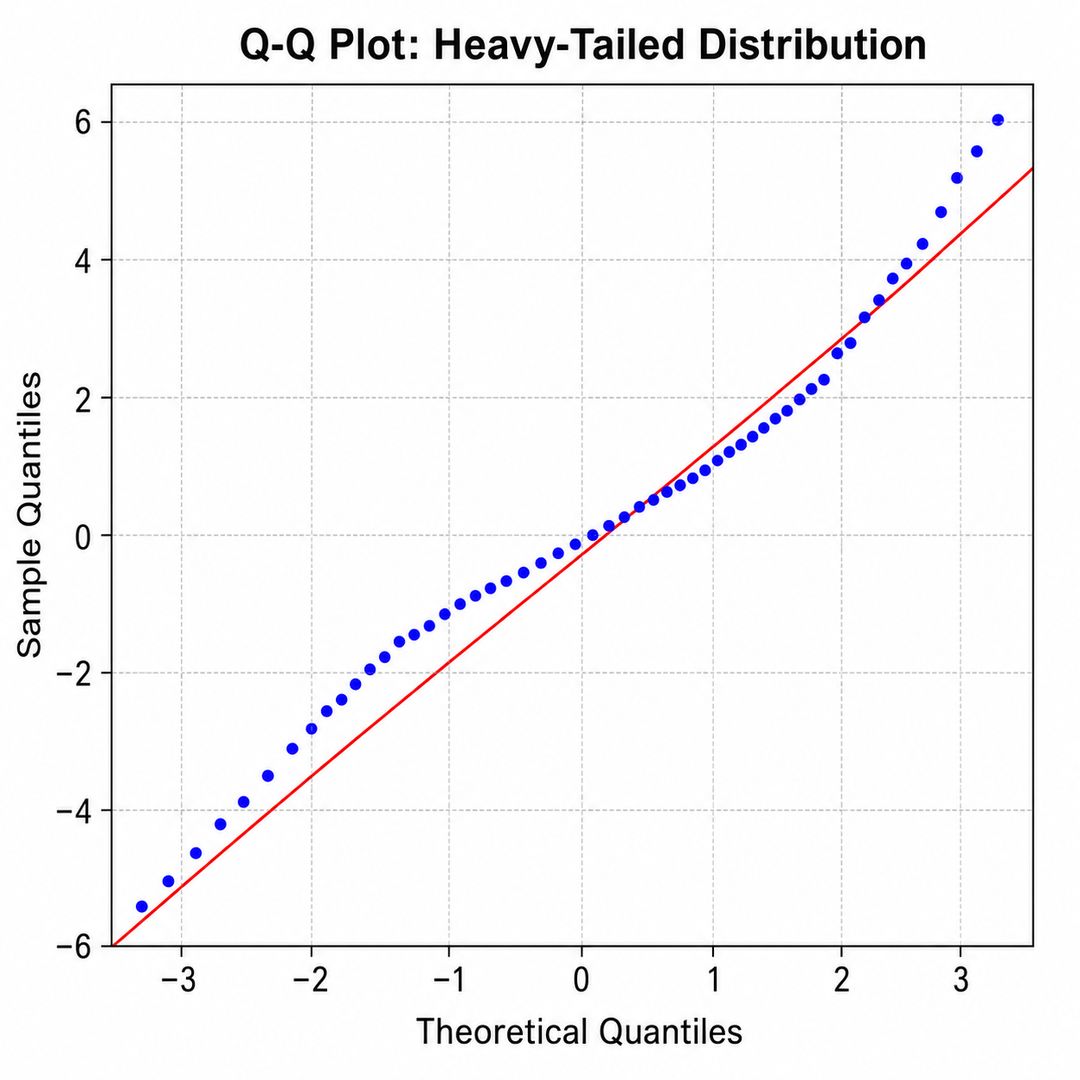
Si raccomanda di non trarre conclusioni definitive sulla causa del fenomeno basandosi esclusivamente sulla forma del grafico: andamenti simili possono derivare da outlier, popolazioni miste, autocorrelazione o da una specificazione errata del modello.
Passo 4: Inserire l'inviluppo di confidenza e gli elementi di contesto
L'inviluppo di confidenza definisce visivamente l'intervallo di variabilità campionaria atteso sotto il modello teorico assunto. I punti che si collocano al di fuori di queste bande meritano un approfondimento, ma l'ampiezza dell'inviluppo non è fissa: essa dipende strettamente dalla numerosità campionaria, dal metodo di stima adottato e dal livello di confidenza impostato.
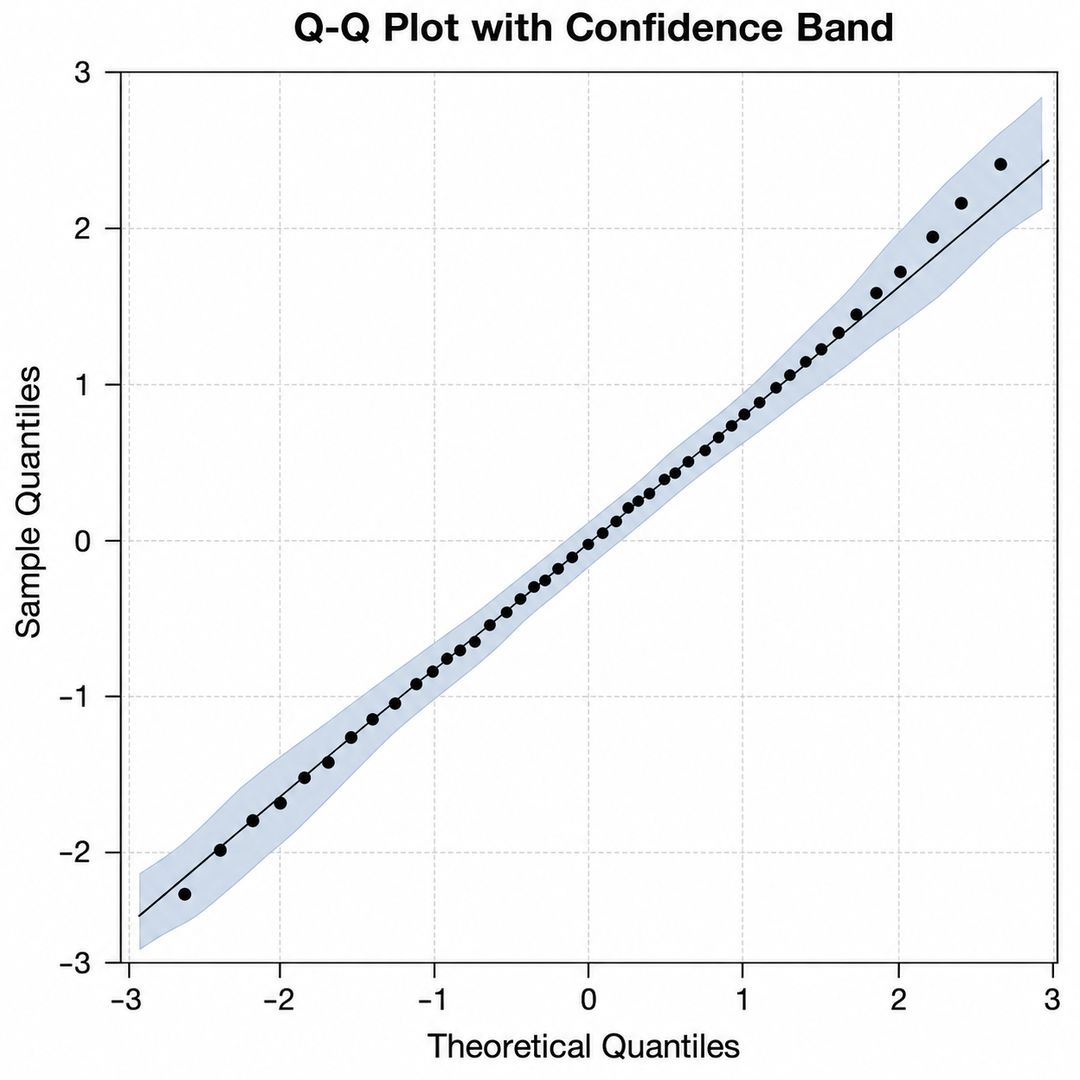
Successivamente, è possibile completare il grafico in SciVis inserendo la denominazione della distribuzione di riferimento, la numerosità del campione ($n$), l'origine dei residui, il livello di confidenza e l'indicazione di eventuali osservazioni di particolare interesse. Se si confrontano più gruppi contemporaneamente, si consiglia di mantenere una scala uniforme e di inserire una legenda chiara per identificare ciascuna serie.
Guida all'interpretazione delle forme tipiche del grafico Q-Q
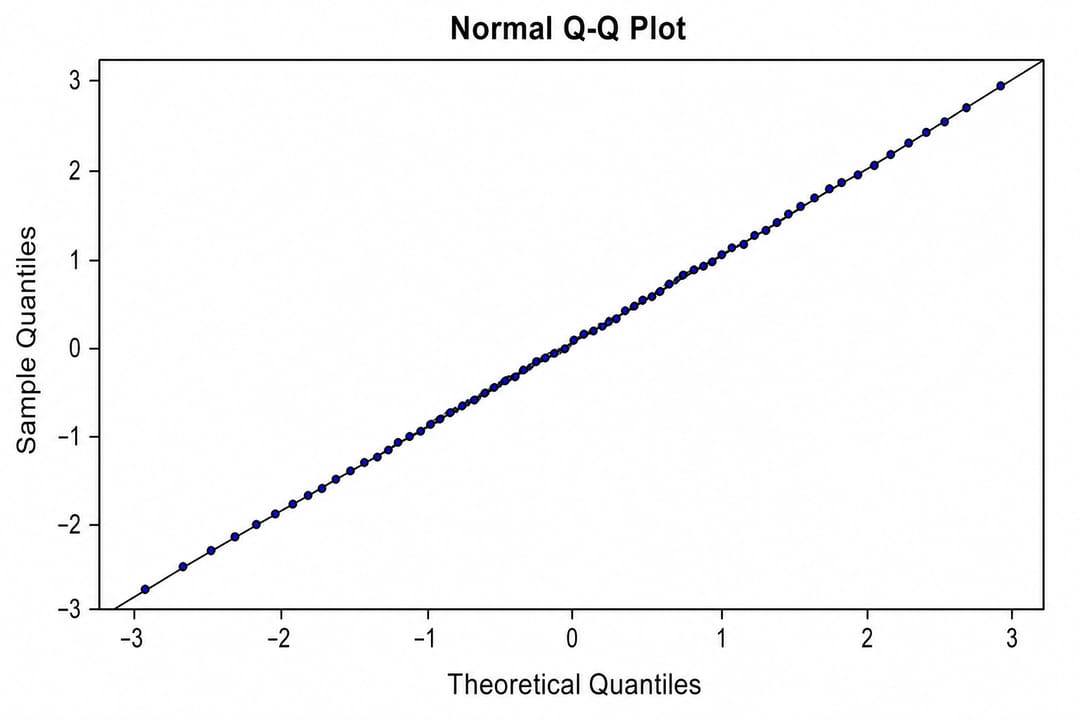
- Punti allineati lungo la retta: il campione è ragionevolmente compatibile con la distribuzione teorica nell'intervallo considerato.
- Deviazioni a forma di "S" sulle code: indicano che il campione presenta code più pesanti o più leggere rispetto alla distribuzione teorica, a seconda della direzione della curvatura.
- Curvatura sistematica concava o convessa: suggerisce la presenza di asimmetria nei dati campionari.
- Uno o due punti marcatamente isolati: evidenziano potenziali valori estremi, anomalie nel caricamento dei dati o osservazioni influenti da esaminare singolarmente.
- Intercetta o pendenza differenti rispetto alla diagonale: indicano differenze nei parametri di posizione (media) o di scala (varianza); in un grafico Q-Q a due campioni, ciò significa che le distribuzioni condividono la forma ma non la centralità o la dispersione.
L'interpretazione del grafico deve sempre tenere conto della dimensione del campione, del disegno sperimentale, di eventuali trasformazioni applicate ai dati, della diagnostica complessiva dei residui e del test statistico che si intende applicare.
Grafico Q-Q o test di normalità formale?
Il grafico Q-Q mostra con precisione dove e in che misura una distribuzione si discosta dal modello teorico. Un test statistico formale (come Shapiro-Wilk o Kolmogorov-Smirnov) sintetizza l'evidenza in un singolo valore di p-value, risultando spesso poco potente con campioni piccoli o, al contrario, eccessivamente sensibile alle minime deviazioni in presenza di campioni molto grandi. La prassi scientifica raccomanda l'uso combinato di entrambi gli approcci, valutando se la deviazione riscontrata possa inficiare la robustezza del metodo statistico scelto.
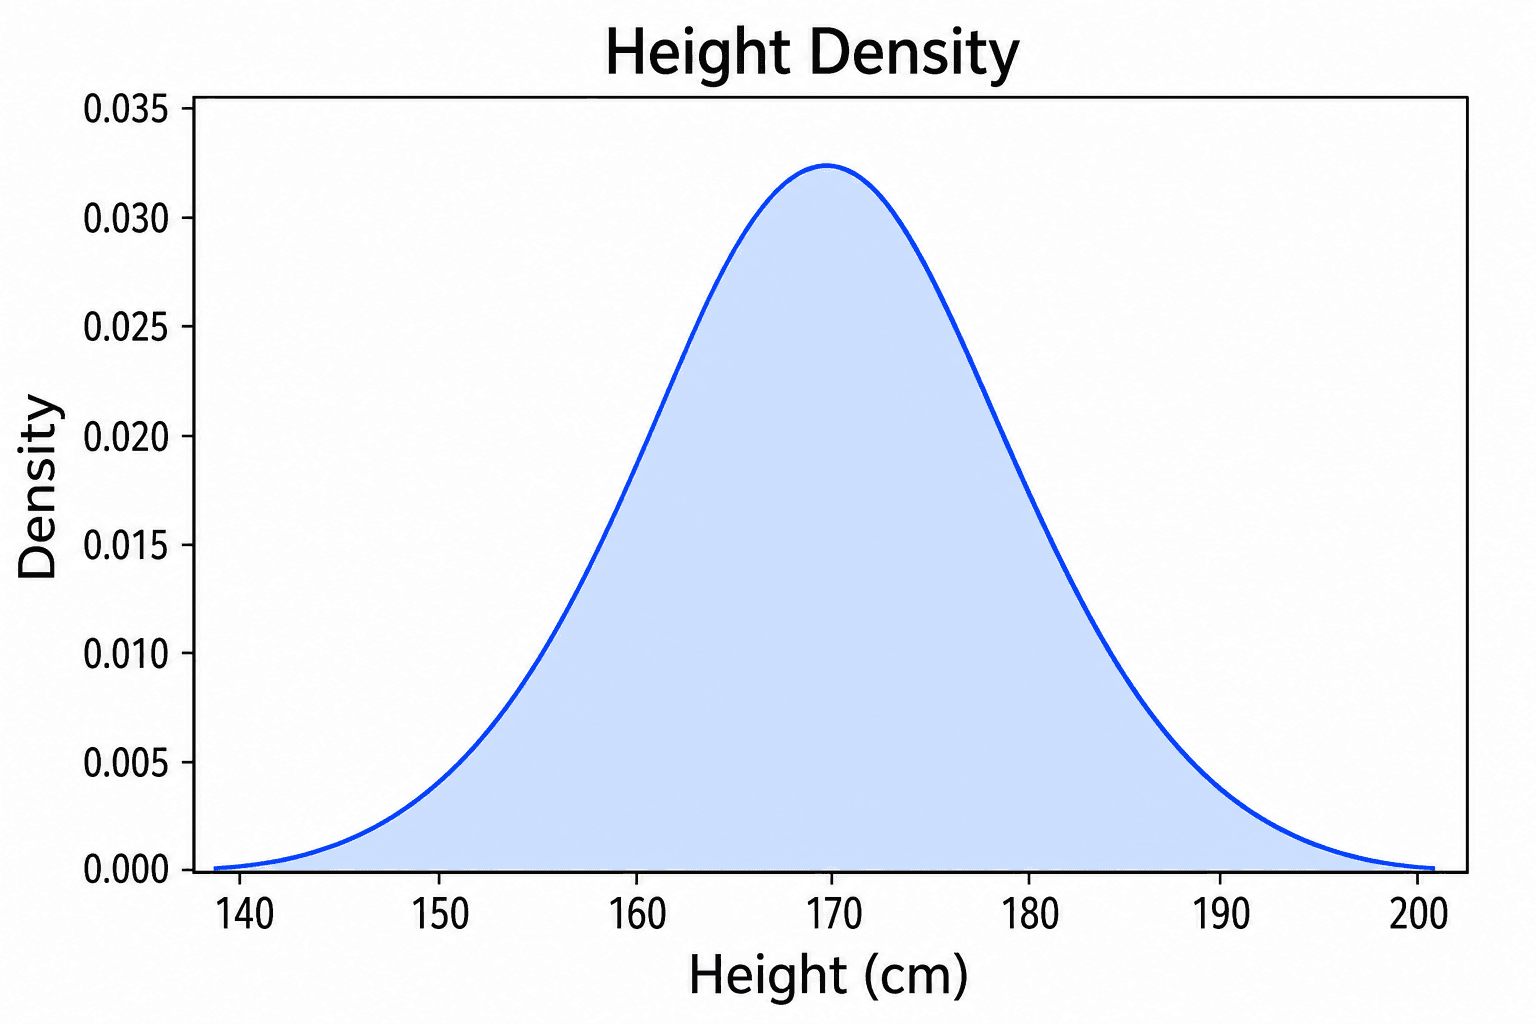
Per l'analisi diretta della distribuzione grezza, strumenti quali l'Histogram Maker, il Density Plot Maker o l'ECDF Plot Generator offrono una prospettiva complementare e altrettanto rigorosa.
Domande frequenti (FAQ)
Un grafico Q-Q lineare dimostra in modo assoluto la normalità dei dati?
No. Dimostra semplicemente la compatibilità visiva del campione con una distribuzione normale di riferimento, data la numerosità campionaria disponibile. Non costituisce una prova matematica che la popolazione di origine sia perfettamente normale.
È corretto eliminare i punti che cadono fuori dalle bande di confidenza?
No. È necessario analizzarne la causa e l'influenza sul modello. L'esclusione di un dato deve basarsi su criteri scientifici documentati o su errori oggettivi nella qualità del dato, non sulla semplice ricerca di una migliore resa grafica.
È possibile applicare il grafico Q-Q ai residui di un modello statistico?
Sì. Il Q-Q plot dei residui è uno standard nella diagnostica dei modelli di regressione. Tuttavia, la normalità è solo uno dei requisiti: occorre verificare anche l'omoschedasticità, l'indipendenza, l'assenza di punti di leva (leverage) e la corretta specificazione del modello stesso.
Si possono confrontare direttamente due campioni empirici?
Sì. Il grafico Q-Q a due campioni confronta direttamente i rispettivi quantili empirici. Se i punti si dispongono lungo una retta, le due distribuzioni hanno una forma analoga; la pendenza e l'intercetta della retta evidenzieranno rispettivamente le differenze nella dispersione e nella tendenza centrale.
Genera il tuo grafico
Inizia configurando i tuoi dati con il Q-Q Plot Maker, definisci chiaramente la distribuzione teorica di riferimento e consulta la nostra guida alla visualizzazione dei dati scientifici per arricchire il tuo lavoro con grafici distributivi complementari.