混淆矩陣產生器
用實驗或研究資料建立 混淆矩陣產生器
根據真實與預測標籤建立二元或多類別混淆矩陣,可顯示計數、標準化百分比並輸出論文用圖。
為研究資料設計可在 SciVis 編輯支援 CSV、TSV、TXT 與 Excel適合論文輸出
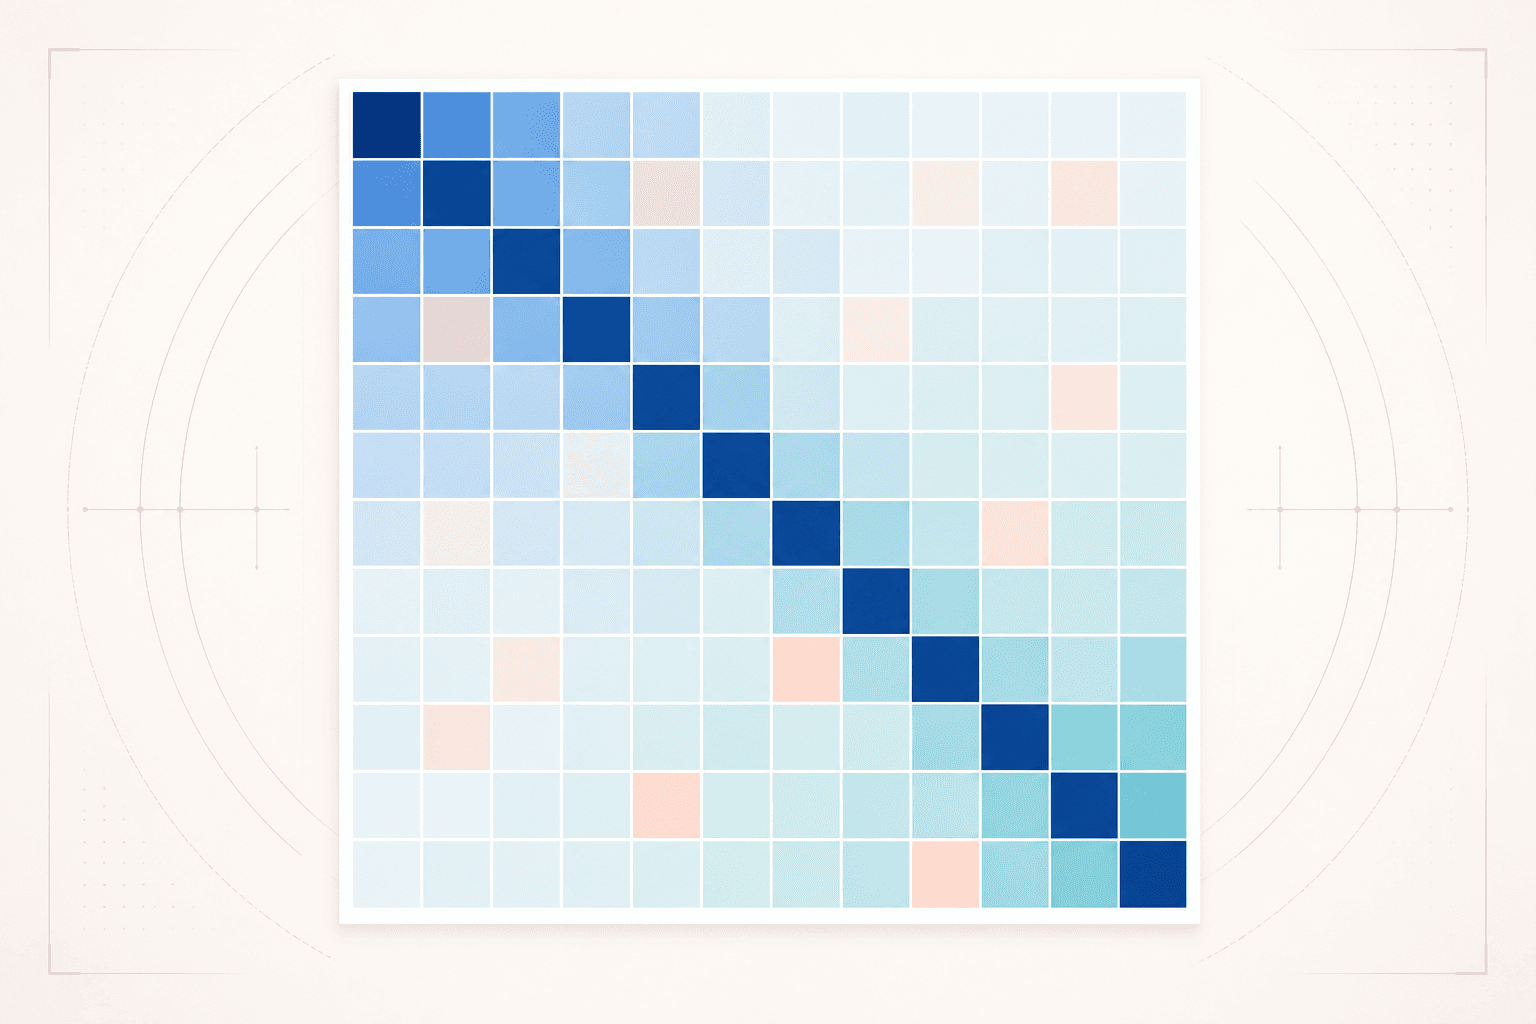
混淆矩陣產生器 範例
查看 6 組可直接使用的資料與視覺風格,涵蓋真實研究情境。
混淆矩陣產生器(Confusion Matrix Generator)能呈現什麼?
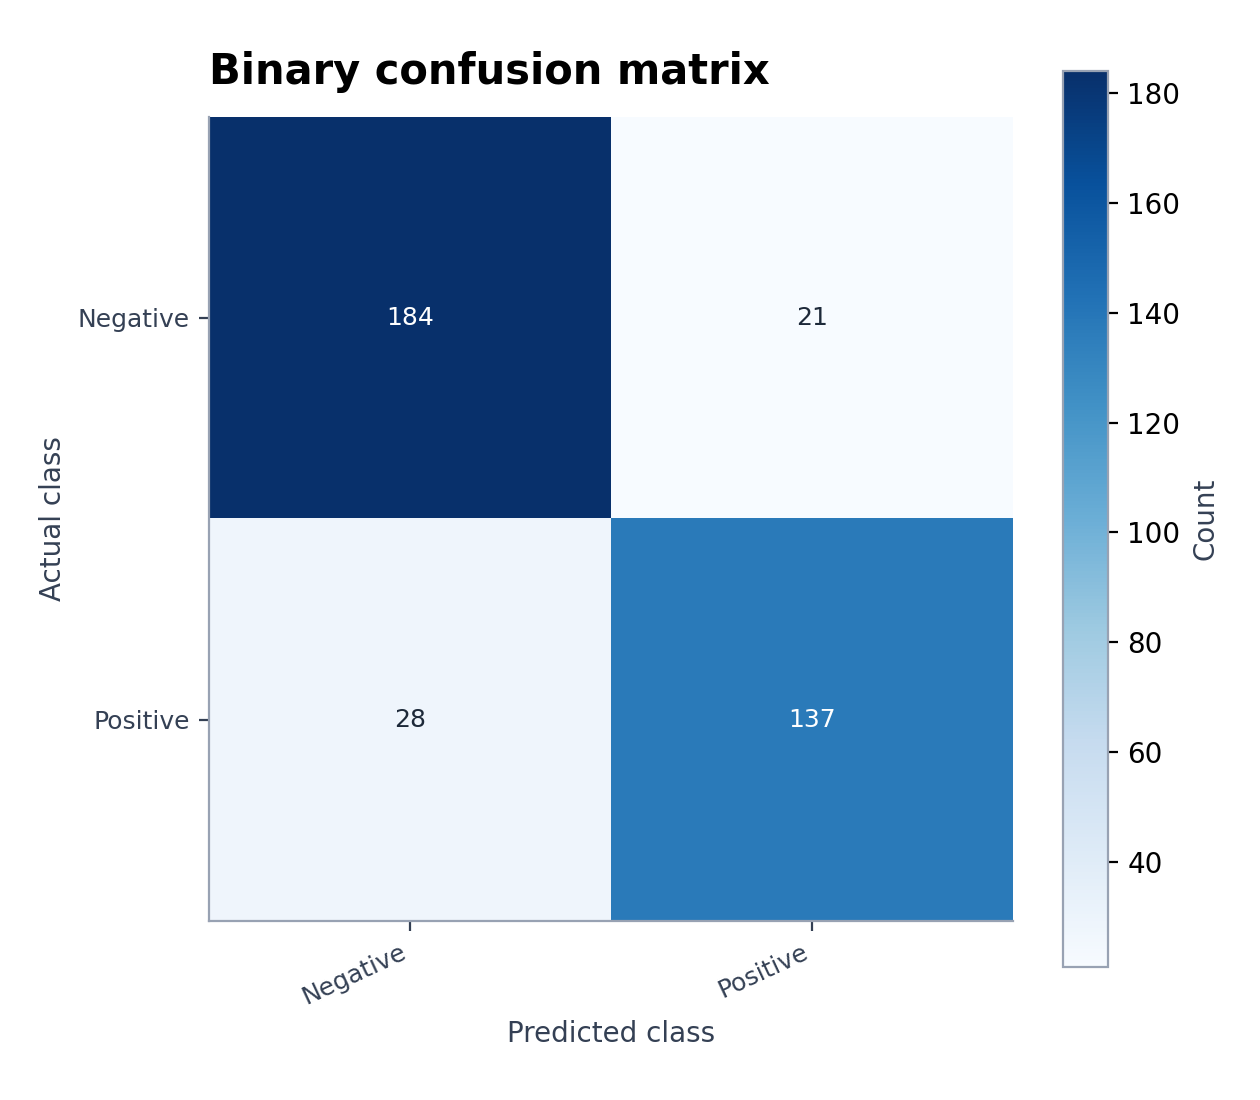
混淆矩陣產生器用於比較實際類別與預測類別,使模型的分類錯誤一目了然,避免被單一的準確度(Accuracy)指標所掩蓋。對角線代表預測正確的數量,非對角線單元格則呈現模型將哪些類別混淆。
混淆矩陣產生器的數據格式要求
- 上傳列層級(row-level)的實際標籤與預測標籤,或已彙整好的類別對應方陣。
- 列與欄必須使用完全相同的類別名稱與排序順序。
- 僅在評估協定有要求時才加入樣本權重(sample weights)。
- 說明單元格數值代表原始計數、列百分比、欄百分比或整體觀測值的比例。
混淆矩陣的學術研究應用範例
- 二元分類混淆矩陣範例
- 多類別混淆矩陣
- 標準化混淆矩陣
- 混淆矩陣熱圖
- 機器學習混淆矩陣
- 含精確率與召回率的混淆矩陣
為什麼評估模型時需要使用混淆矩陣?
- 識別是哪些類別導致了偽陽性(False Positives)與偽陰性(False Negatives)。
- 偵測高整體準確度背後是否掩蓋了少數類別預測表現不佳的問題。
- 比較原始計數與標準化後的類別層級比率。
- 利用匯出的預測結果,快速生成具可重複性的模型評估圖表。
如何使用 混淆矩陣產生器
選擇範例,或上傳一個 CSV、TSV、TXT、XLSX、XLS 檔案;檢查辨識出的欄位,產生圖表,再進入 SciVis 編輯。Excel 僅匯入第一個工作表。
一張清晰的混淆矩陣應包含哪些要素
- 明確標示「實際值(Actual)」與「預測值(Predicted)」的軸標籤。
- 排序一致的類別名稱。
- 單元格數值搭配易讀的漸層單色調色盤。
- 圖表說明中須註明測試集、標準化方法與樣本總數。
該選擇混淆矩陣還是 ROC 曲線?
當需要檢視特定決策門檻下的類別預測結果時,請使用混淆矩陣。若要評估跨門檻的整體性能,請使用 ROC 曲線或精確率–召回率曲線(Precision-Recall Curve)。針對不平衡數據,PR 曲線通常比 ROC 曲線更具參考價值。
混淆矩陣產生器 常見問題
混淆矩陣產生器需要哪些數據欄位?
最簡單的輸入格式為一欄實際標籤(actual label)與一欄預測標籤(predicted label)。您也可以直接提供已彙整好的計數方陣。
我應該對混淆矩陣進行標準化(Normalization)嗎?
使用原始計數可呈現樣本規模,而使用列標準化百分比則便於比較各類別的召回率(Recall)。請務必在圖表中明確說明標準化的基準與分母。
用 混淆矩陣產生器 產生後還能繼續編輯嗎?
可以。用 混淆矩陣產生器 產生後開啟 SciVis,即可修改標籤、配色、註解、版面與其他視覺設定。
混淆矩陣產生器 的圖可以用於論文嗎?
可以。混淆矩陣產生器 以清楚、適合發表的科學圖表為目標;投稿前仍應核對資料與期刊要求。
混淆矩陣產生器 可以輸出高解析度圖嗎?
可以。混淆矩陣產生器 圖在 SciVis 完成編輯後,可依論文、海報、投影片與報告用途輸出。
使用 混淆矩陣產生器 需要會寫程式嗎?
不需要。混淆矩陣產生器 透過引導式上傳流程建立初稿,後續可用 SciVis 的視覺控制細修。