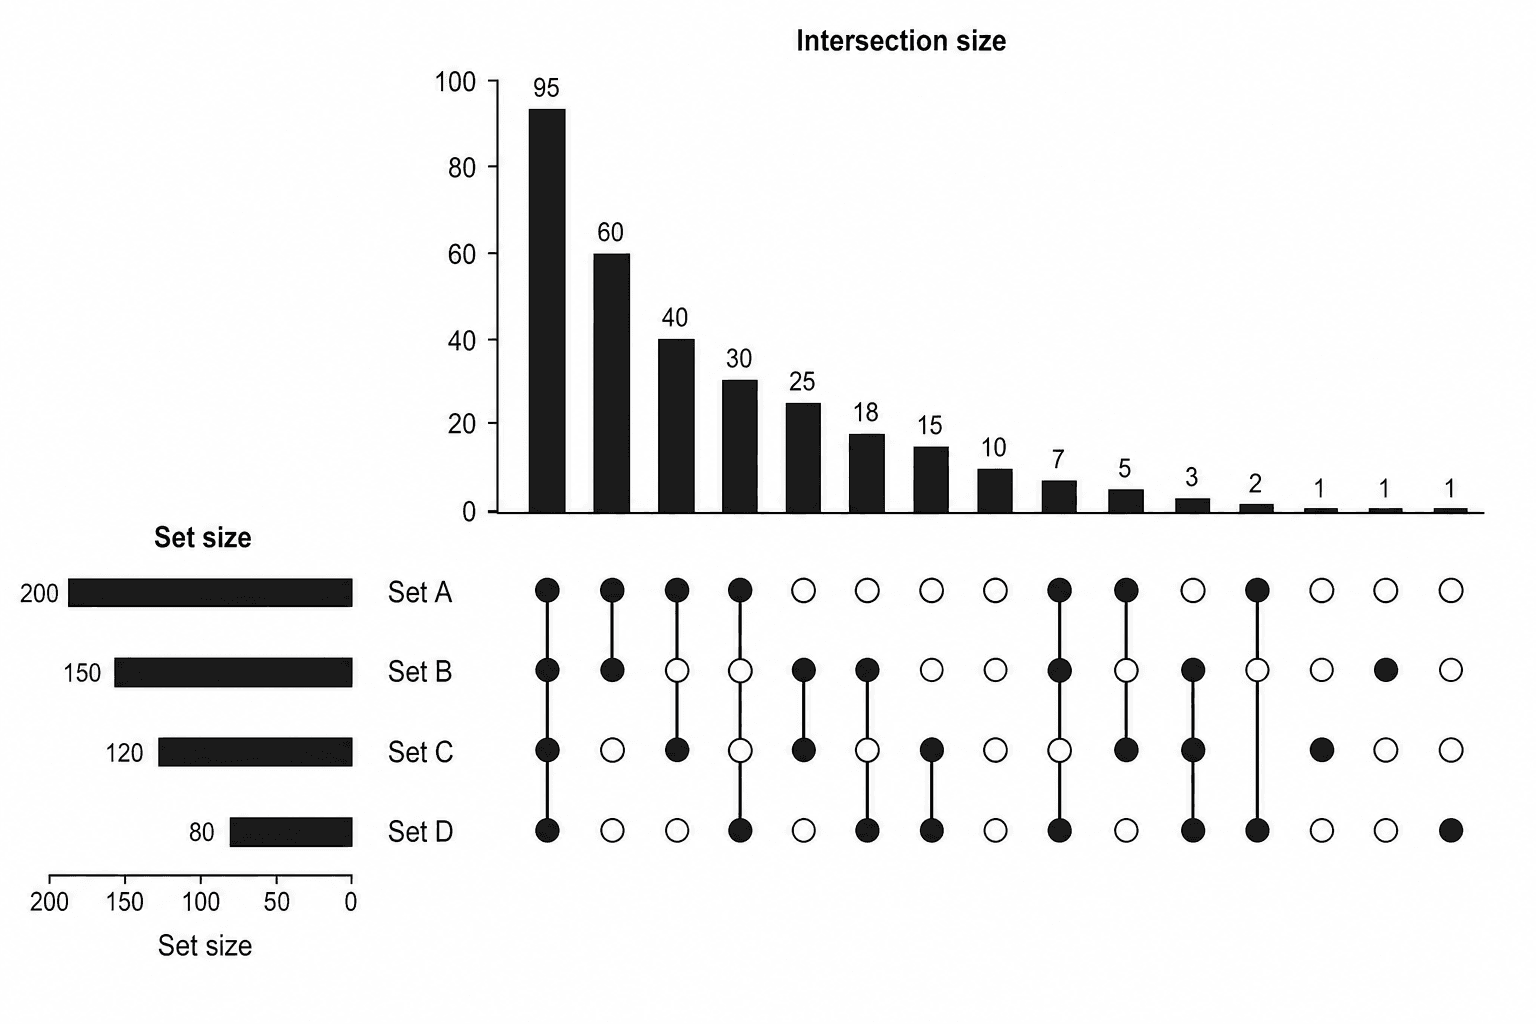
Диаграмма Венна, содержащая пять и более кругов, часто не упрощает восприятие информации, а лишь запутывает читателя. Области пересечений становятся слишком мелкими для размещения подписей, визуально сопоставить их площади практически невозможно, а некоторые важные пересечения легко упустить из виду. Диаграмма UpSet (UpSet plot) решает эту проблему, заменяя накладывающиеся друг на друга геометрические фигуры наглядной матрицей пересечений и выровненными столбчатыми диаграммами.
Используйте генератор диаграмм UpSet от SciDraw, если перед вашим исследованием стоит задача сопоставить пересечения между несколькими списками генов, когортами пациентов, наборами признаков, биологическими видами, метаболическими путями или экспериментальными условиями. Генератор принимает структурированную таблицу принадлежности и передает полученный результат в редактор SciVis для финальной доработки.
Распространенные ошибки при создании диаграмм UpSet
- Двойной учет пересечений: четко определите, отображают ли столбцы эксклюзивные (взаимоисключающие) пересечения или же совместные наложения.
- Использование несогласованных идентификаторов: записи вида
Gene-1,gene1иGene_1могут распознаваться системой как совершенно разные объекты. - Наличие дубликатов внутри одного множества: принадлежность обычно кодируется бинарно; повторяющиеся записи не должны искусственно завышать объем пересечения.
- Сортировка без явного указания принципа: столбцы пересечений могут быть упорядочены по размеру, по степени пересечения или по определенному биологическому приоритету.
- Отображение слишком большого числа минорных пересечений: отсекайте единичные совпадения только по четко сформулированному правилу, сохраняя при этом полные исходные данные в сопроводительных материалах.
Какие данные требуются для построения диаграммы UpSet?
В примерах SciDraw используется широкая таблица бинарной принадлежности (binary membership table):
| Столбец | Назначение | Пример |
|---|---|---|
item | Уникальный объект (идентификатор) | Gene_001 |
Control | Принадлежность к контрольной группе (Control) | 1 или 0 |
Treatment_A | Принадлежность к группе воздействия A (Treatment A) | 1 or 0 |
Treatment_B | Принадлежность к группе воздействия B (Treatment B) | 1 or 0 |
Treatment_C | Принадлежность к группе воздействия C (Treatment C) | 1 or 0 |
Validation | Принадлежность к проверочной группе (Validation) | 1 or 0 |
highlight | Дополнительная аннотация (необязательно) | yes or no |
Добавьте по одному столбцу на каждое множество; в базовом примере их пять.
Вы можете скачать базовый CSV-файл UpSet или пример с наборами генов. Каждая строка должна описывать строго один уникальный объект, а в столбцах множеств должно использоваться единообразное представление истинности/ложности.
Шаг 1: Определение множеств перед визуализацией
Четко сформулируйте критерии, по которым объект включается в то или иное множество. Для списков дифференциально экспрессируемых генов это может быть строгое пороговое значение скорректированного p-value и кратности изменения (fold change), одинаковое для всех условий. Для клинических когорт — задокументированные критерии включения. Помните, что визуализация не способна исправить методологические ошибки в определении исходных групп.
Шаг 2: Загрузка таблицы принадлежности
Перейдите в генератор диаграмм UpSet, выберите один из шести демонстрационных примеров или загрузите собственный файл в формате CSV, TSV, TXT, XLSX или XLS. Внимательно изучите область предварительного просмотра на предмет дублирующихся идентификаторов, пустых ячеек и столбцов, которые по ошибке распознались как текстовые.
Шаг 3: Проверка матрицы и столбчатых диаграмм
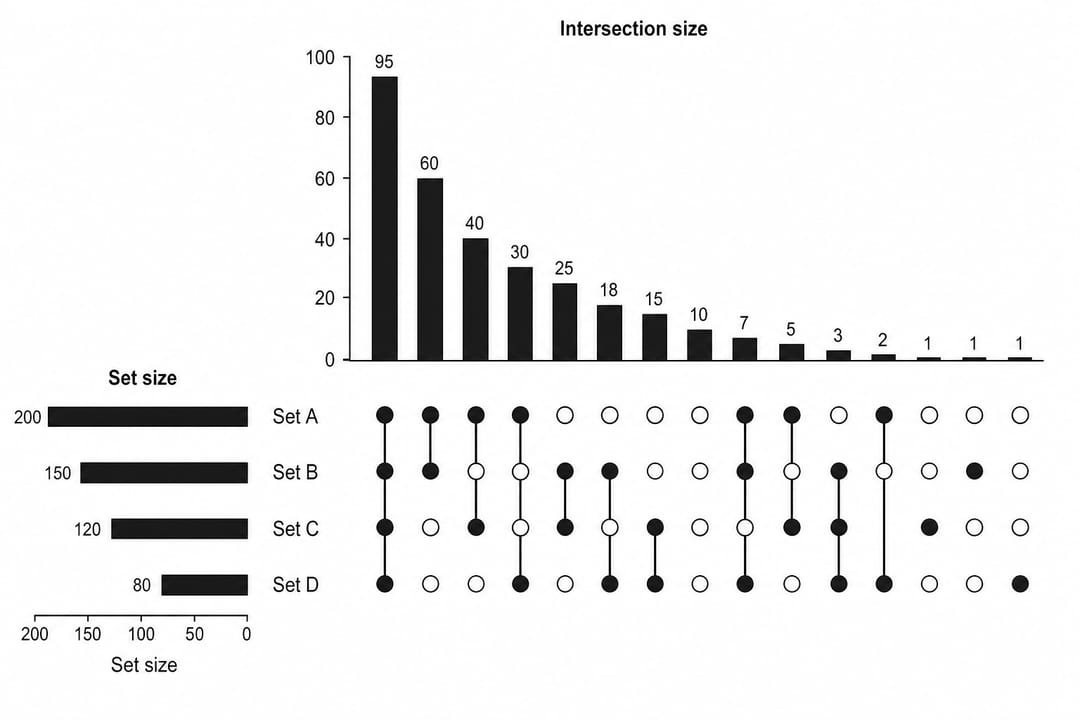
Каждому столбцу матрицы соответствует определенное пересечение множеств. Закрашенные точки показывают, какие именно множества входят в данное пересечение, а вертикальная линия связывает их, если в пересечении участвуют два и более множества. Высота столбца над этим элементом матрицы отражает количественный размер данного пересечения. Горизонтальные столбцы в левой части диаграммы показывают общий объем каждого из исходных множеств.
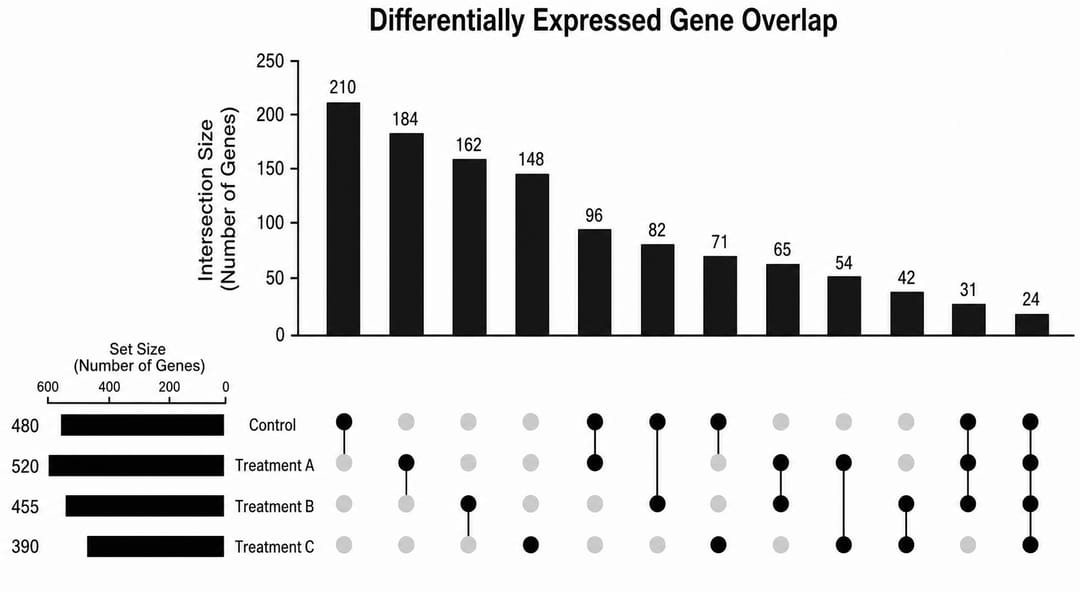
Вручную рассчитайте несколько ключевых пересечений непосредственно по исходной таблице и сверьте их с высотой столбцов на графике. Эта проверка критически важна, если вы применяли фильтрацию данных или если один и тот же объект изначально мог фигурировать в нескольких исходных файлах.
Шаг 4: Выбор обоснованного порядка сортировки
Сортировка по размеру пересечения (intersection size) помогает читателю мгновенно определить наиболее масштабные совпадения. Сортировка по степени пересечения (degree) группирует данные по числу пересекающихся множеств: сначала одиночные множества, затем попарные совпадения, затем тройные и так далее. Пользовательский порядок сортировки оправдан в тех случаях, когда ключевое значение для исследования имеет конкретное предопределенное сравнение, однако не следует настраивать его лишь для того, чтобы искусственно выделить желаемый результат.
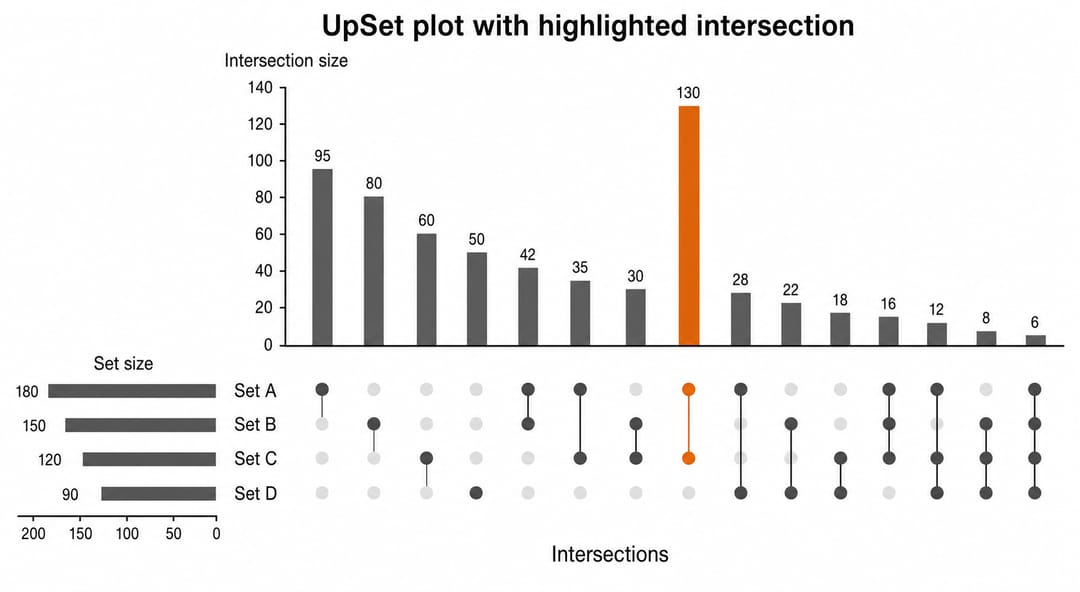
Используйте SciVis для тонкой настройки подписей, расстояний между элементами и цветовой гаммы. Вы можете выделить цветом одно наиболее важное с биологической точки зрения пересечение, оставив остальные элементы матрицы нейтрально-серыми.
Как правильно читать диаграмму UpSet
Выберите интересующий вас столбец на верхней диаграмме размеров пересечений, опустите взгляд вниз на соответствующий ему столбец точек в матрице и посмотрите, напротив каких множеств стоят закрашенные маркеры. Например, если закрашенные точки стоят напротив строк Treatment A и Treatment B, но отсутствуют напротив Control, то при эксклюзивном типе пересечений данный столбец показывает количество объектов, принадлежащих строго этой паре групп.
Помните, что общие размеры множеств (горизонтальные столбцы слева) и размеры их пересечений (вертикальные столбцы сверху) отвечают на совершенно разные вопросы. Крупное по объему множество может содержать крайне мало уникальных объектов, если практически все его элементы распределены по пересечениям с другими группами.
Что выбрать: диаграмму UpSet или диаграмму Венна?
- Используйте инструмент для создания диаграмм Венна для визуализации двух или трех множеств, когда привычная пространственная метафора наложения кругов облегчает восприятие.
- Используйте диаграмму UpSet, если число анализируемых множеств равно четырем и более, либо когда вам необходимо максимально точно и количественно сопоставить размеры пересечений.
- Используйте генератор диаграмм Санкей, если ваша научная задача связана с отображением динамики переходов или потоков данных, а не со статическим анализом принадлежности к группам.
Часто задаваемые вопросы (FAQ)
Можно ли построить диаграмму UpSet без использования языка R?
Да, конечно. Загрузите таблицу бинарной принадлежности в наш генератор диаграмм UpSet, постройте базовый график и перейдите к его детальному оформлению в редакторе SciVis.
Могут ли столбцы принадлежности содержать значения TRUE и FALSE?
Да, использование согласованных логических значений (Boolean) допускается. Тем не менее, в наших демонстрационных шаблонах используются цифры 1 и 0, поскольку они интерпретируются абсолютно однозначно в любых версиях CSV-файлов и табличных процессоров.
Что такое степень пересечения (intersection degree)?
Степень пересечения — это количество множеств, участвующих в данном конкретном совпадении. Одиночная закрашенная точка соответствует степени один; три соединенные точки указывают на степень пересечения, равную трем.
Обязательно ли выводить на график абсолютно все возможные пересечения?
Не обязательно. В сложных системах со множеством групп неизбежно возникает большое количество пустых или незначительных пересечений. Вместо того чтобы вручную удалять неудобные столбцы, примените прозрачное и воспроизводимое правило фильтрации (например, по минимальному размеру пересечения или по топ-N пересечениям) и обязательно укажите его в методике исследования.
Создайте свою визуализацию
Начните работу в генераторе диаграмм UpSet, сверьте ключевые количественные показатели с исходной таблицей принадлежности и обратитесь к нашему руководству по научной визуализации данных для выбора других подходящих типов графиков.